En un comité de dirección industrial, un despliegue de inteligencia artificial suele aprobarse tras una confirmación tranquilizadora: «los servidores de la base de datos están alojados en Frankfurt». Para los equipos de operaciones y desarrollo de negocio, esto parece resolver cualquier objeción de privacidad frente a clientes exigentes.
Sin embargo, en las auditorías técnicas de seguridad y homologación de proveedores surge el desfase real. El almacenamiento estático de documentos puede residir en la Unión Europea, mientras que la inferencia en tiempo de ejecución del modelo fundacional (el momento en el que el prompt se procesa en la GPU) se ejecuta bajo enrutamientos geográficos distintos según el tipo de suscripción, la arquitectura del proveedor o la disponibilidad de cómputo. Si queréis evaluar el marco general, podéis revisar las claves de regulación de IA antes de desarrollar. auditoría de ciberseguridad.
Comprender la residencia de datos en IA exige superar la simplificación geográfica tradicional. Para un directivo de tecnología, la cuestión no es únicamente en qué disco duro descansan los archivos, sino dónde se computan los datos, quién ostenta el control operativo y legal, y qué riesgos residuales asume la compañía en cada interacción.
Qué significa realmente la residencia de datos en IA
La residencia de datos define la ubicación física y geográfica en la que una organización almacena y procesa su información digital. En sistemas tradicionales (como ERPs, CRMs o bases de datos relacionales), este concepto solía limitarse a la región del centro de datos asignado.
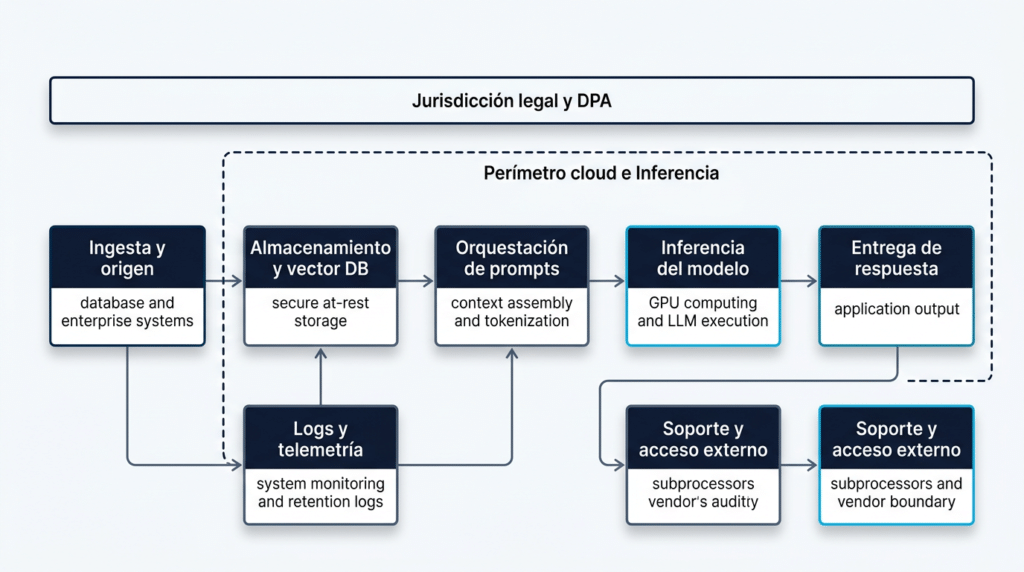
En los sistemas basados en modelos de lenguaje (LLM) y modelos multimodales, esta definición resulta insuficiente. Un flujo de IA descompone la información en múltiples capas operativas: bases vectoriales, llamadas de API, procesamiento volátil en GPU, capas de moderación de contenido y registros de telemetría. Por tanto, la residencia del dato debe analizarse tanto en reposo (at rest) como en tránsito (in transit) y en procesamiento (in use).
Almacenamiento, procesamiento, transferencia y jurisdicción: cuatro conceptos diferentes
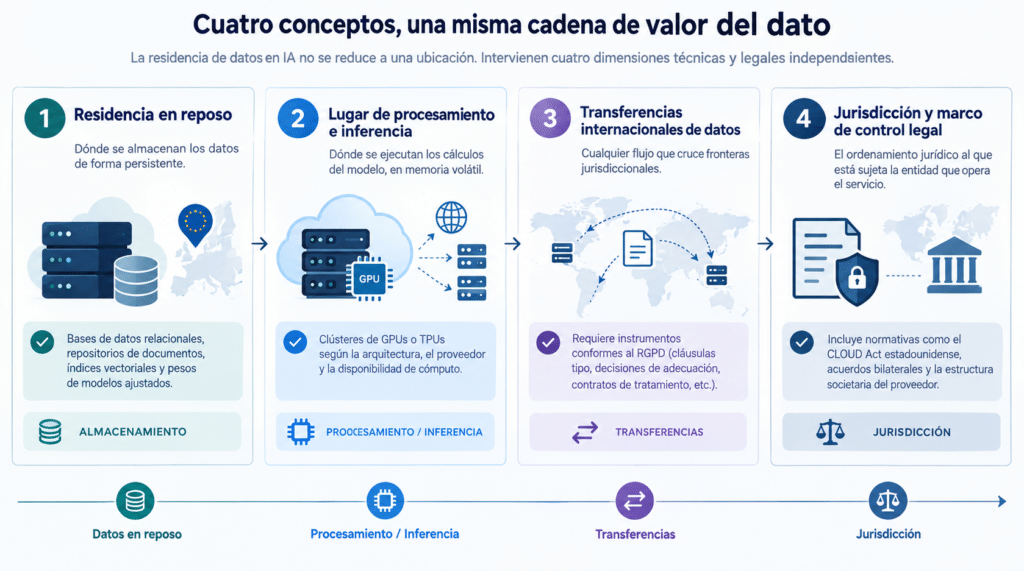
Uno de los errores más frecuentes al evaluar arquitecturas de IA es considerar que un único acuerdo o ubicación resuelve el gobierno del dato. En la práctica, intervienen cuatro dimensiones técnicas y legales independientes:
- Residencia en reposo: La región geográfica donde residen los datos almacenados de forma persistente (bases de datos relacionales, repositorios de documentos, índices vectoriales y pesos de modelos ajustados).
- Lugar de procesamiento e inferencia: La infraestructura computacional concreta (clústeres de GPUs o TPUs) donde se carga el prompt en memoria volátil para calcular la respuesta. Puede coincidir o no con la región de almacenamiento.
- Transferencias internacionales de datos: Cualquier flujo en el que la información o sus metadatos cruzan fronteras jurisdiccionales, requiriendo instrumentos conformes al RGPD (como cláusulas contractuales tipo o decisiones de adecuación). Tener datos en Europa no equivale automáticamente a cumplir el RGPD, pues este exige bases jurídicas, minimización, contratos de tratamiento y medidas técnicas proporcionales.
- Jurisdicción y marco de control legal: El ordenamiento jurídico al que está sometida la entidad que opera el servicio. Por ejemplo, normativas extraterritoriales como el CLOUD Act estadounidense establecen mecanismos para requerir datos a proveedores sujetos a su jurisdicción con independencia del país donde ubiquen físicamente sus centros de datos, si bien su aplicación real depende de la estructura societaria, el control efectivo sobre la información y los tratados bilaterales aplicables.
La cadena completa del dato en una arquitectura de IA
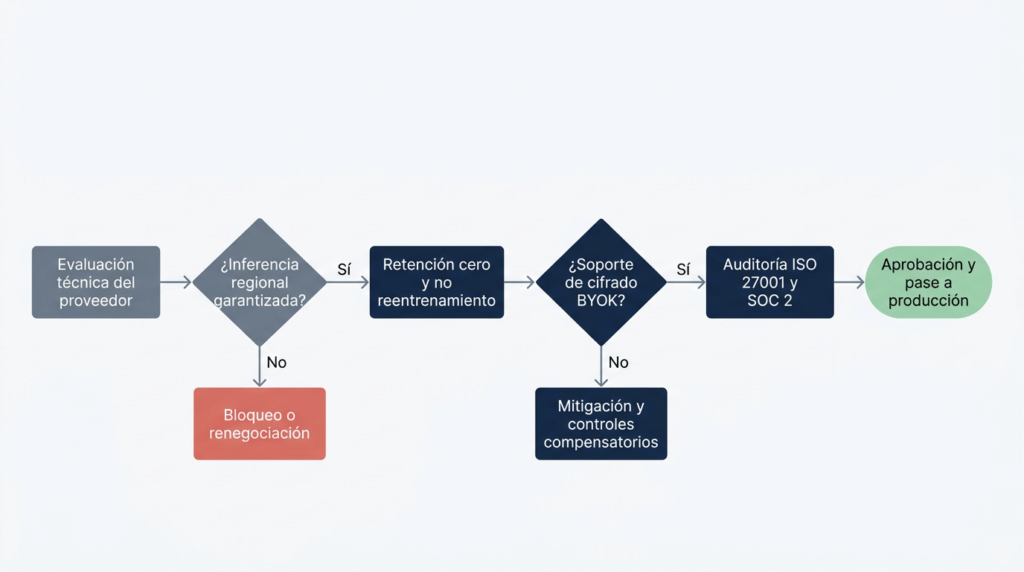
Para determinar si vuestra arquitectura preserva la soberanía de la información corporativa, debéis mapear cada salto del ciclo de vida del dato. Esto resulta especialmente crítico en arquitecturas de generación aumentada por recuperación (RAG):
- Documentos fuente y repositorios corporativos: Archivos CAD, ofertas comerciales, manuales de planta o historiales de clientes alojados en vuestros sistemas internos. Antes de conectarlos, conviene auditar si disponéis de datos preparados para un proyecto de IA.
- Generación de embeddings y base de datos vectorial: Los textos se convierten en representaciones numéricas mediante un modelo de embeddings. La base vectorial puede residir en vuestra propia red o en un servicio gestionado en la nube.
- Ensamblado del prompt: La aplicación combina la consulta del usuario con el contexto recuperado, creando el payload final que se envía al modelo.
- Inferencia en el modelo fundacional: La llamada viaja hacia la API del proveedor o hacia un servidor local. Es aquí donde se ejecuta el cálculo computacional. RAG es un patrón arquitectónico de consulta, no una garantía intrínseca de residencia; si los embeddings o la inferencia acuden a APIs externas sin aislamiento geográfico, el dato sensible viaja con ellos.
- Políticas de retención y logs de abuso: Muchos proveedores registran entradas y salidas para depuración, detección de abusos o monitorización técnica durante periodos predeterminados por la política del proveedor y la configuración contratada, salvo que se contrate o configure expresamente un esquema de Zero Data Retention (ZDR).
- Entrenamiento continuo vs. procesamiento: Es fundamental no confundir la cláusula de «no utilizar datos para reentrenamiento» con la garantía de «no transferir datos fuera de una región geográfica». Son dos salvaguardas distintas e independientes.
Comparativa técnica: OpenAI, Microsoft Azure y Google Cloud
Al seleccionar modelos comerciales, no basta con revisar el folleto general. Las capacidades de aislamiento geográfico dependen estrictamente del producto (API vs. interfaces corporativas), del tipo de despliegue, del modelo elegido y de los términos contractuales firmados. Conviene analizar estos factores junto con los criterios para elegir LLM en vuestra empresa.
|
Proveedor |
Almacenamiento (At Rest) |
Procesamiento / Inferencia |
Controles de Residencia |
Qué debe comprobar la empresa |
|---|---|---|---|---|
|
OpenAI |
Permite configurar residencia en la UE para datos en reposo en planes Enterprise y determinados acuerdos API. |
La residencia de datos y la residencia de inferencia son controles distintos. OpenAI ofrece opciones de inferencia regional para clientes elegibles y determinados productos; la cobertura depende del producto, región, modelo y configuración contratada. |
Políticas de retención cero (ZDR) configurables bajo solicitud técnica/comercial en endpoints específicos de la API. |
Comprobar si vuestro contrato incluye procesamiento geográfico estricto y no solo almacenamiento; validar qué modelos soportan ZDR. |
|
Microsoft Azure OpenAI |
Confinado a la región seleccionada del recurso de Azure dentro de la Unión Europea (EU Data Boundary). |
Depende del tipo de despliegue: Global (enruta a cualquier centro mundial), Data Zone (confinado a Europa) o Regional (centro de datos local específico). |
Control de claves mediante Customer-Managed Keys (BYOK/CMK), redes privadas virtuales y opción de exclusión de monitorización de abusos para clientes aprobados. |
Verificar la cuota disponible en despliegues Data Zone para los modelos requeridos antes de dimensionar arquitectura. |
|
Google Cloud (Vertex AI / Gemini) |
Permite fijar la región europea para el almacenamiento de datos de clientes y artefactos de modelos, según modelo, endpoint y funcionalidad utilizada. |
Disponible procesamiento en regiones específicas europeas para endpoints soportados; ciertas funcionalidades auxiliares o modelos beta pueden tener alcance global. |
Garantías contractuales de no uso de datos para entrenar modelos fundacionales, integración con VPC-Service Controls y cifrado administrado por el cliente (CMEK). |
Revisar los compromisos de Data Residency específicos de cada versión de Gemini y excluir servicios auxiliares que impliquen procesamiento transfronterizo. |
El uso de claves de cifrado gestionadas por el cliente (BYOK/CMEK) aporta una capa adicional de control criptográfico para los datos en reposo, pero no anula por sí solo las consideraciones sobre dónde se desencripta el dato temporalmente en memoria para su procesamiento.
De la nube centralizada al edge: evaluación de arquitecturas de IA
Frente a la nube pública multitenant, los equipos técnicos pueden articular distintas estrategias arquitectónicas según el grado de sensibilidad del proceso:
- Nube multitenant con Data Zone estricta: Ofrece acceso inmediato a los modelos más avanzados delegando el mantenimiento de hardware, siempre que se configuren cuotas y endpoints regionales auditados.
- Modelos de pesos abiertos (open-weight) en infraestructura privada: Desplegar modelos abiertos (como las familias Llama o Mistral) en vuestra propia VPC en Europa o en servidores on-premise elimina la dependencia de APIs externas. Sin embargo, no proporciona «soberanía absoluta» de forma mágica: traslada al equipo interno la responsabilidad sobre la seguridad del sistema operativo, el aprovisionamiento de GPUs, la cadena de suministro de software y los costes asociados. Podéis profundizar en este dilema en nuestra comparativa sobre Cloud vs On-Premise para empresas.
- Edge computing en planta industrial: Ejecutar inferencia en dispositivos industriales locales resulta idóneo para líneas de producción con requisitos de baja latencia o información operacional crítica que no debe salir de la fábrica.
- Arquitecturas híbridas con sanitización previa: Un esquema pragmático consiste en desplegar módulos locales que anonimizan variables confidenciales (fórmulas químicas, identificadores de clientes, costes de adquisición) antes de remitir consultas enriquecidas a modelos cloud de mayor capacidad. Para analizar cómo estructurar estos flujos operativos, revisad nuestro análisis sobre automatizaciones vs agentes de IA.
A través de nuestras soluciones de inteligencia artificial industrial, ayudamos a diseñar entornos donde el control del dato convive con la eficiencia de los procesos productivos.
Checklist técnico: 15 preguntas clave para evaluar a vuestro proveedor
Antes de autorizar la integración de un modelo fundacional en un entorno de producción corporativo, el equipo de IT, ciberseguridad y compras debe documentar las siguientes respuestas:
- Ubicación de almacenamiento: ¿En qué región geográfica exacta residen las bases de datos vectoriales, historiales y documentos de contexto?
- Ubicación de la inferencia: ¿En qué centros de datos físicos se ejecutan los cálculos matriciales del modelo durante la llamada de API?
- Mecanismos de enrutamiento: ¿Existe derivación dinámica (global routing) a clústeres fuera de la región contractual en momentos de alta saturación?
- Continuidad y Disaster Recovery: En caso de contingencia o failover, ¿el tráfico se redirige a centros dentro de la misma jurisdicción europea?
- Logs de telemetría y diagnósticos: ¿Qué información técnica o de contenido se registra de forma automática tras cada llamada?
- Periodo de retención: ¿Durante cuántos días persisten los logs y en qué condiciones se puede solicitar Zero Data Retention?
- Acceso del personal técnico: ¿Qué perfiles del proveedor tienen acceso a los registros de soporte o depuración y bajo qué protocolos de control?
- Compromiso de no entrenamiento: ¿Consta en el contrato B2B una cláusula vinculante que prohíba expresamente utilizar los prompts y respuestas para entrenar o calibrar modelos generales?
- Subprocesadores involucrados: ¿Qué empresas subcontratadas intervienen en el procesamiento, moderación de contenido o soporte técnico?
- Entidad jurídica firmante: ¿El acuerdo se formaliza con una filial europea o directamente con una entidad matriz extranjera?
- Instrumentos de transferencia: ¿Qué mecanismos jurídicos y contractuales amparan las eventuales transferencias internacionales de metadatos?
- Cifrado en tránsito y en reposo: ¿Qué algoritmos y estándares criptográficos se aplican en todas las fases de la comunicación?
- Capacidades de gestión de claves: ¿Admite el servicio Customer-Managed Keys (BYOK/CMEK) para revocar accesos en reposo de forma unilateral?
- Certificaciones y auditorías independientes: ¿Acredita el proveedor informes periódicos SOC 2 Tipo II, certificación ISO 27001 o esquemas sectoriales auditados?
- Evidencias contractuales auditables: ¿Ofrece el proveedor compromisos por escrito y métricas de cumplimiento verificables ante un requerimiento legal o de auditoría?
Impacto en compras, homologación y ciclo de negocio
El rigor en la gobernanza de la IA no es un ejercicio teórico: tiene un impacto directo en la relación con clientes y en la sostenibilidad financiera de las iniciativas.
En sectores como la automoción, la energía, el ámbito químico o la fabricación de bienes de equipo, los departamentos de compras y seguridad bloquean con frecuencia la integración de herramientas que presenten opacidad sobre sus flujos de datos. Disponer de un expediente técnico claro sobre la residencia y el tratamiento de la información permite responder con rapidez a cuestionarios de ciberseguridad, facilitando los procesos de homologación.
Asimismo, evaluar estos aspectos desde la fase de diseño evita costes imprevistos. Migrar a posteriori una solución debido a un veto de cumplimiento legal incrementa notablemente el coste total de propiedad (TCO). Si queréis estimar adecuadamente el presupuesto de un despliegue, podéis examinar cómo calcular el TCO al implementar IA.
El método Datipic: cómo estructurar una arquitectura de IA fiable
Integrar capacidades avanzadas de modelos de lenguaje sin perder el control de los activos industriales requiere un enfoque sistemático. En Datipic acompañamos a las organizaciones a través de una metodología estructurada en seis fases operativas:
- Clasificación del dato y caso de uso: Identificamos los datos involucrados en cada proceso, catalogándolos según su nivel de confidencialidad y exigencia regulatoria.
- Mapeo del flujo de información: Trazamos el recorrido íntegro de la información desde su origen hasta la salida, identificando cada componente técnico intermedio.
- Evaluación de proveedores y modelos: Contrastamos las opciones disponibles (APIs comerciales, modelos open-weight en servidor privado o entornos edge) analizando latencia, coste y aislamiento legal.
- Diseño de arquitectura técnica: Definimos la topología de red, las capas de anonimización previa, las bases vectoriales y los mecanismos de cifrado pertinentes.
- Evaluación de TCO, rendimiento y seguridad: Cuantificamos los costes computacionales recurrentes, validamos tiempos de respuesta y comprobamos el cumplimiento de las políticas de retención.
- Validación antes de producción: Ejecutamos pruebas piloto controladas para verificar que ningún flujo desvíe información sensible antes del despliegue corporativo definitivo.
Con este marco, los equipos directivos adoptan la IA con criterios verificables, reduciendo incertidumbres técnicas y asegurando la compatibilidad con sus clientes industriales.
Preguntas frecuentes sobre residencia de datos en IA
¿Qué diferencia hay entre residencia y soberanía de datos?
La residencia describe dónde se almacenan o procesan los datos. La soberanía incorpora además las leyes, jurisdicciones, estructuras de control y capacidad de una organización para gobernar el acceso y tratamiento de esa información. Por eso, una arquitectura puede tener residencia europea y seguir planteando cuestiones de jurisdicción o control que deban analizarse.
¿Dónde se procesan los datos enviados a un LLM?
Depende de la arquitectura contratada, del proveedor, del modelo, del endpoint y de la configuración contratada. Algunos servicios permiten seleccionar regiones o zonas de procesamiento, mientras que otros ofrecen opciones de procesamiento global. Solo mediante configuraciones específicas (como despliegues Data Zone o modelos alojados en infraestructura privada) se acota el procesamiento a una región determinada.
¿Tener los datos en Europa garantiza el cumplimiento del RGPD?
No necesariamente. La residencia geográfica en la Unión Europea es una condición relevante, pero el RGPD exige además formalizar contratos de encargo de tratamiento (DPA), aplicar medidas técnicas adecuadas, evaluar transferencias accesorias de telemetría y garantizar los derechos de los interesados.
¿Es más segura una IA on-premise que una IA en la nube?
Un despliegue local o en infraestructura privada elimina el envío de información a terceros y reduce el riesgo de transferencias internacionales no autorizadas. Sin embargo, exige que la empresa asuma íntegramente la gestión de la seguridad del sistema, los parches de vulnerabilidades y el mantenimiento del hardware, por lo que su nivel de seguridad global dependerá de la madurez operativa del equipo interno.
¿Qué debe preguntar una empresa a su proveedor de IA antes de firmar?
Debe solicitar confirmación por escrito sobre tres aspectos esenciales: la ubicación física de la inferencia computacional, el compromiso de no utilización de datos para reentrenar modelos fundacionales y las políticas de retención y acceso a los registros de logs y telemetría.
Solicita una evaluación de residencia y arquitectura de tu caso de uso de IA
Llevar soluciones de inteligencia artificial a producción no requiere comprometer la confidencialidad de vuestros secretos industriales ni asumir riesgos legales innecesarios. La clave reside en seleccionar la arquitectura adecuada para cada proceso operativo.
En Datipic analizamos vuestros casos de uso para diseñar infraestructuras robustas y eficientes. A través de nuestro diagnóstico técnico, vuestro equipo obtendrá:
- Un mapa detallado de flujos de datos y puntos críticos de procesamiento.
- Una evaluación de riesgos regulatorios y de residencia del dato adaptada a vuestro sector.
- Un análisis comparativo de proveedores y modelos de lenguaje idóneos.
- Una propuesta de arquitectura (cloud restringido, híbrido u on-premise) con estimación realista de TCO.
Os invitamos a solicitar una evaluación técnica con nuestro equipo para diseñar un despliegue de IA seguro, gobernable y rentable desde el primer día.