Imaginemos una empresa del sector industrial que decide acelerar sus operaciones implementando un asistente de inteligencia artificial para sus técnicos de mantenimiento en planta. El objetivo operativo es evidente: acelerar el diagnóstico de paradas no programadas cruzando manuales de fabricantes, telemetría de PLCs y registros históricos de averías.
El equipo técnico levanta una prueba de concepto en pocas semanas consumiendo una API comercial. La solución sorprende positivamente en las primeras pruebas internas, pero cuando el proyecto pasa al comité de seguridad e IT para su despliegue general, la iniciativa se paraliza. Nadie había validado si los esquemas de maquinaria contenían propiedad industrial bajo acuerdos de confidencialidad, qué ocurría con los registros de intervención firmados por operarios ni si el proveedor del modelo conservaba los datos para reentrenamiento.
Este caso ilustra el dilema recurrente al que se enfrentan CIOs, CTOs y directores de innovación: la aceleración en el despliegue de soluciones inteligentes suele chocar con vacíos de gobernanza técnica y regulatoria. Cuando la conformidad legal se trata como una auditoría de última hora previa al pase a producción, el resultado casi siempre implica rediseñar tuberías de datos, reescribir integraciones o descartar arquitecturas completas. Para evitar este cuello de botella financiero y operativo, conviene evaluar desde el diseño si están tus datos preparados para un proyecto de IA y qué exigencias normativas condicionarán vuestra infraestructura.
Qué marco normativo afecta a un proyecto de IA empresarial
Antes de diseñar la arquitectura técnica, conviene asentar los cimientos de cumplimiento normativo. De este modo, garantizamos un enfoque integral de compliance by design desde la primera fase. En este contexto, las organizaciones deben alinear sus procesos técnicos con los requerimientos jurídicos vigentes para evitar riesgos operacionales.
Al Abordar la regulación de IA, debes tener en cuenta antes de desarrollar un proyecto de IA requiere superar la tentación de tratar el marco regulatorio como un único texto legal. Sin embargo, en el entorno empresarial europeo, cualquier solución con algoritmos predictivos o generativos cruza varios cuerpos jurídicos concurrentes. Por consiguiente, para estructurar este análisis sin fricciones entre los departamentos técnico y legal, resulta imprescindible separar cuatro capas diferenciadas:
- Regulación general y sectorial de IA: Esta capa está encabezada en la Unión Europea por el Reglamento de Inteligencia Artificial (Reglamento UE 2024/1689 o AI Act). Dicho marco clasifica las aplicaciones según su nivel de riesgo. Asimismo, impone obligaciones técnicas de transparencia, supervisión y documentación. Además, a estas pautas se suman directivas de responsabilidad por productos defectuosos y normativas sectoriales, como la directiva de ciberseguridad NIS2 o las regulaciones financieras y sanitarias.
- Privacidad y protección de datos: En este ámbito, rige el Reglamento General de Protección de Datos (RGPD). Esta normativa aplica siempre que el pipeline procese información que identifique o haga identificable a una persona física. Por ello, sus principios deben respetarse tanto en el entrenamiento o fine-tuning como en la inferencia operativa.
- Seguridad de la información: Incluye controles técnicos y organizativos para preservar la confidencialidad, integridad y disponibilidad del sistema. Por ejemplo, previene riesgos frente a inyecciones de prompts o extracciones de modelos. Por otra parte, bloquea accesos no autorizados a bases vectoriales.
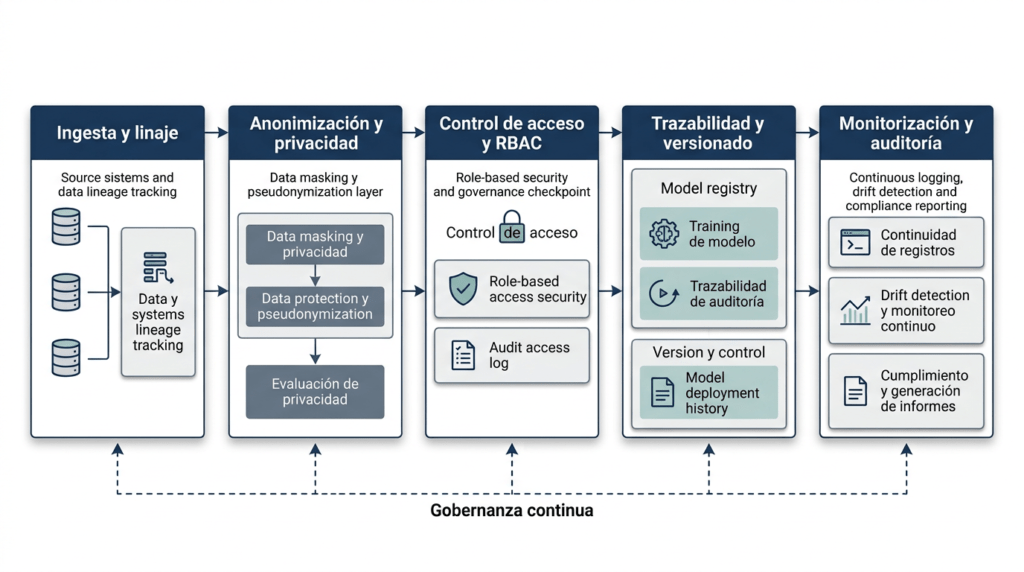
- Gobernanza corporativa del dato: Comprende políticas internas de linaje y control de accesos a la información. De igual forma, abarca el inventario de activos algorítmicos y la validación de sesgos. Finalmente, define mecanismos de contingencia operativa para asegurar la continuidad del negocio.
AI Act: qué debe comprobar una empresa antes de desarrollar IA
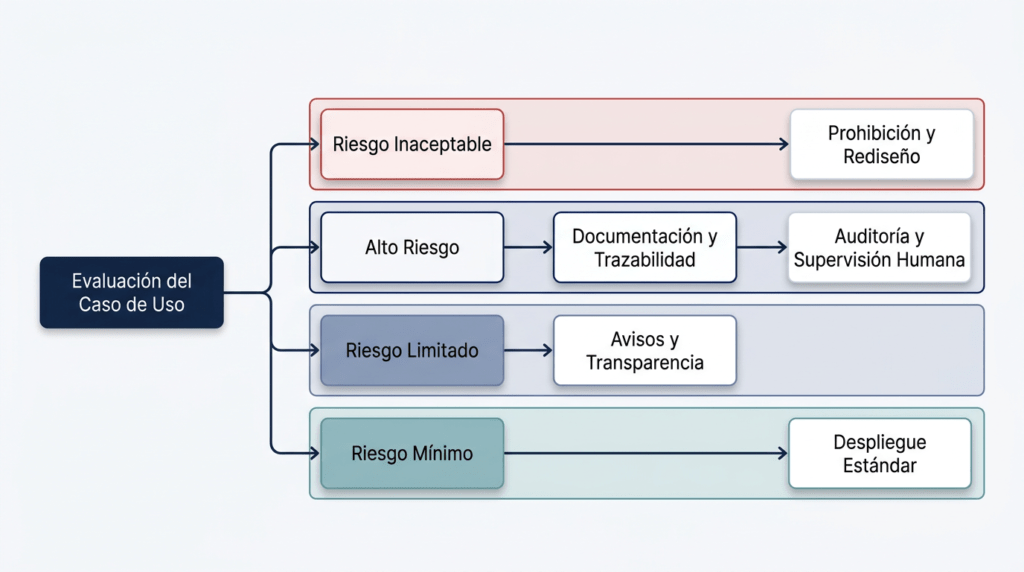
En primer lugar, el AI Act europeo no aplica las mismas reglas a todos los algoritmos. Tampoco impone cargas idénticas a cualquier desarrollo de software. Por tanto, su arquitectura legislativa se articula en torno al riesgo del caso de uso previsto. De este modo, la norma distingue categorías muy claras:
- Prácticas de riesgo inaceptable (prohibidas): Incluyen casos extremos como la manipulación conductual con perjuicio real o la puntuación social generalizada. Asimismo, abarcan ciertas modalidades de biometría en tiempo real en espacios públicos. En consecuencia, estas soluciones no pueden comercializarse ni ponerse en servicio.
- Sistemas de alto riesgo: Son aplicaciones cuyo impacto en los derechos fundamentales o en la seguridad resulta significativo. Sin embargo, conviene aclarar un error habitual. El empleo de IA en una industria o infraestructura crítica no convierte automáticamente la herramienta en alto riesgo. Para encajar en esta categoría, el sistema debe ser un componente de seguridad sujeto a evaluación externa previa por normativas sectoriales. Además, se incluyen supuestos tasados específicos, como la gestión de recursos humanos (triaje algorítmico o evaluación del rendimiento) y la concesión crediticia.
- Sistemas con obligaciones específicas de transparencia: Se trata de herramientas generativas o soluciones que interactúan directamente con personas. Por consiguiente, es obligatorio informar al usuario de que dialoga con una máquina. Igualmente, resulta necesario marcar de forma reconocible los contenidos sintéticos generados.
- Sistemas de riesgo mínimo o nulo: Abarcan la gran mayoría de aplicaciones operativas, como filtros de spam o clasificación interna de inventario no crítico. Por ello, no sufren restricciones operativas especiales, más allá de aplicar las buenas prácticas habituales de la industria.
Modelos de IA de propósito general (GPAI)
Una novedad crucial del AI Act es la regulación de los modelos de propósito general (GPAI), como los grandes modelos fundacionales (LLMs). En este sentido, la norma impone deberes de documentación técnica y resúmenes sobre datos de entrenamiento. Asimismo, exige el respeto a la propiedad intelectual, principalmente a los proveedores que comercializan estos modelos base.
Por otra parte, si un modelo supera capacidades computacionales de 10^(25) FLOPs acumulados, se cataloga con riesgo sistémico. Por esta razón, se le exigen evaluaciones de resiliencia frente a incidentes graves y mitigación de ciberamenazas.
Para una empresa usuaria, entender este matiz es vital. Ciertamente, integrar un LLM comercial vía API traslada parte del cumplimiento al proveedor fundacional. Sin embargo, esta integración no exime a vuestra organización de las responsabilidades derivadas de la aplicación final que construyáis sobre él.
Calendario de aplicación del Reglamento de IA
Además, el reglamento establece una entrada en vigor escalonada. Por tanto, los comités de IT deben incorporar estas fechas clave en su hoja de ruta tecnológica:
|
Fecha |
Ámbito de aplicación principal |
Impacto en proyectos corporativos |
|---|---|---|
|
2 febrero 2025 |
Aplicación de las prohibiciones de determinadas prácticas de IA y de las obligaciones de alfabetización en IA. |
Por un lado, conviene revisar el inventario de casos de uso para identificar prácticas prohibidas. Además, es necesario establecer medidas de formación y alfabetización en IA. |
|
2 agosto 2025 |
Aplicación de las normas de gobernanza y de las obligaciones para modelos de IA de propósito general (GPAI). |
Por consiguiente, se deben revisar los proveedores de modelos fundacionales, su documentación y las condiciones de uso asociadas. |
|
2 agosto 2026 |
Aplicación general del AI Act, incluidas determinadas obligaciones de transparencia y las competencias de supervisión y ejecución. |
Asimismo, resulta clave integrar el cumplimiento del AI Act en los procesos de gobierno de IA, la evaluación de proveedores y el diseño de nuevos casos de uso. |
|
2 diciembre 2027 |
Aplicación de las obligaciones para determinados sistemas de IA de alto riesgo del Anexo III, incluidos casos relacionados con empleo, infraestructuras críticas, educación, biometría o acceso a determinados servicios. |
En este caso, los proyectos de estas categorías deberán incorporar requisitos de gestión de riesgos, documentación y supervisión humana. Del mismo modo, exigirán garantizar la calidad de los datos. |
|
2 agosto 2028 |
Aplicación de las obligaciones para sistemas de IA de alto riesgo integrados en productos regulados del Anexo I. |
Este hito resulta especialmente relevante para empresas industriales. Por tanto, los sistemas de IA integrados en productos regulados por la UE deberán cumplir los requisitos de alto riesgo aplicables. |
Provider, deployer y proveedor tecnológico: quién asume qué responsabilidad
Muchas veces, en la toma de decisiones técnicas, se asume por error que el proveedor de software responderá ante cualquier contingencia legal. Sin embargo, el AI Act distingue con total nitidez dos figuras jurídicas clave:
- Proveedor (Provider): Es la persona física o jurídica que desarrolla un sistema de IA o un modelo GPAI. Además, lo comercializa o pone en servicio bajo su propia marca, exista o no contraprestación económica.
- Responsable del despliegue (Deployer): Corresponde a la entidad (vuestra empresa) que utiliza el sistema de IA bajo su autoridad profesional. Por tanto, quedan excluidos los usos de carácter estrictamente personal.
Por ejemplo, si vuestra organización contrata una herramienta SaaS empaquetada y sigue las instrucciones del fabricante, vuestro rol principal será el de deployer. En este contexto, vuestras obligaciones exigen garantizar datos de entrada representativos para el fin previsto. Asimismo, debéis mantener una supervisión humana adecuada durante toda la operativa. Por consiguiente, tendréis que monitorizar el funcionamiento continuo y suspender el uso si detectáis riesgos no previstos.
No obstante, existe un riesgo técnico de gran calado en la adaptación de sistemas. Imaginad que vuestro equipo toma un modelo abierto de terceros y le aplica un ajuste fino sobre datos propios. Si además modificáis sustancialmente su finalidad o lo comercializáis con marca propia, el escenario cambia por completo. En consecuencia, vuestra organización podría asumir las obligaciones adicionales de un proveedor bajo los criterios del AI Act.
Datos, privacidad y RGPD en proyectos de IA
El entusiasmo por los modelos generativos suele diluir los límites entre las distintas tipologías de información corporativa. Por esta razón, desarrollar un proyecto sin incidentes exige clasificar los datos de entrada con exactitud:
- Datos de carácter personal: Incluyen cualquier dato asociado a una persona física identificada o identificable, como operarios, clientes o proveedores. Por tanto, si intervienen en el proyecto, aplican los principios de minimización y limitación de la finalidad del RGPD. Asimismo, debéis asegurar una base de legitimación adecuada.
- Información confidencial y secretos empresariales: Abarcan parámetros de maquinaria, formulaciones químicas, costes operativos o márgenes comerciales. Aunque no caen bajo el RGPD, su envío a servidores externos sin controles adecuados genera riesgos graves. En consecuencia, pueden producirse divulgaciones no autorizadas, incumplimientos contractuales o la pérdida de control sobre activos protegidos.
- Datos seudonimizados vs. anonimizados: Sustituir nombres por códigos numéricos representa una seudonimización básica. Sin embargo, la información sigue considerándose dato personal si existe modo de revertir la relación. Por el contrario, la anonimización exige romper el nexo causal de forma irreversible. Además, debe evaluarse el riesgo real de reidentificación por cruce de variables, ya que no basta con borrar cabeceras de correos.
En España, las directrices de la Agencia Española de Protección de Datos (AEPD) son muy claras al respecto. En primer lugar, recuerdan que el RGPD aplica al recopilar datos para el dataset de entrenamiento. Del mismo modo, la normativa rige sobre los datos procesados en la inferencia y sobre la información de salida del modelo.
Por consiguiente, si vuestra arquitectura analiza patrones laborales de los empleados, conviene extremar las precauciones. Esto es crítico cuando los resultados sirvan para tomar decisiones con efectos jurídicos o significativos. En tales casos, tendréis que analizar las garantías de tratamiento automatizado y perfilado bajo el RGPD, incluyendo la intervención humana cuando corresponda.
Arquitectura de despliegue: APIs propietarias, cloud privado, on-premise y modelos open-weight
La selección de la infraestructura tecnológica define de manera directa las garantías de privacidad y la superficie de exposición regulatoria. Por tanto, no existe una solución universalmente superior para todas las empresas. Cada alternativa equilibra con precisión el nivel de control, la latencia, el coste y la complejidad:
- APIs de modelos propietarios (SaaS): Permiten arrancar con gran velocidad. Además, ofrecen capacidades cognitivas punteras sin exigir inversión en hardware especializado. No obstante, requieren revisar con exhaustividad los contratos vigentes. Por consiguiente, debéis verificar la retención temporal de inferencias y la prohibición explícita de usar vuestras peticiones para el reentrenamiento.
- Despliegue de modelos open-weight en cloud privado o servidores dedicados: Esta vía utiliza pesos abiertos ejecutados en instancias propias, como AWS, Azure, GCP o data centers locales. De este modo, se asegura que el tráfico nunca abandone vuestro perímetro de red. Sin embargo, conviene desterrar un mito frecuente. Contar con un modelo open-weight o ejecutarlo on-premise no otorga conformidad regulatoria automática ni garantiza la soberanía del dato. Por tanto, una infraestructura local sin controles de acceso, auditoría de eventos o cifrado seguirá siendo vulnerable e incumplirá los estándares normativos.
- Modelos open-weight: Permiten acceder a los pesos del modelo bajo los términos de su licencia específica. Sin embargo, esta condición no implica necesariamente que el código, los datos de entrenamiento o el resto de componentes del sistema sean abiertos.
- Modelos open source: Por su parte, conviene reservar esta denominación de manera estricta. En consecuencia, utilizad este término solo cuando las licencias y la disponibilidad efectiva de todos los componentes permitan sostenerlo técnicamente.
Para profundizar en los criterios técnicos de cómputo y costes recurrentes según el tipo de arquitectura, podéis revisar nuestra guía sobre cómo elegir un LLM para vuestra empresa.
RAG, fine-tuning y LLMs: evaluación técnica de riesgos y límites
Al implementar modelos de lenguaje en procesos corporativos, surgen dudas sobre cómo anclar las respuestas a la verdad documental de la organización. Sin embargo, conviene analizar las capacidades y límites reales de cada enfoque técnico:
Límites operativos de la arquitectura RAG
La generación aumentada por recuperación (RAG) se ha consolidado como un estándar en la industria. Este enfoque permite alimentar a un modelo con bases documentales privadas sin incurrir en el coste de entrenar desde cero. Además, representa una técnica eficaz para mejorar la precisión y citar fuentes internas. No obstante, RAG no garantiza por sí solo la fiabilidad del sistema ni la ausencia total de alucinaciones. Por consiguiente, tampoco asegura de manera automática el cumplimiento de los requisitos de explicabilidad o supervisión.
- En primer lugar, no suprime de forma absoluta las alucinaciones. Esto sucede cuando el modelo fundacional sintetiza creativamente información ante un contexto ambiguo.
- Asimismo, la arquitectura está expuesta a fallos en la capa de recuperación (retrieval). Entre ellos destacan la segmentación inadecuada (chunking), la indexación errónea en la base vectorial o la presencia de documentos obsoletos. Por tanto, tales incidencias perjudican la explicabilidad exigida por los reguladores.
- Por esta razón, se requiere observabilidad continua sobre la similitud semántica. De igual modo, conviene supervisar la relevancia del ranking para asegurar respuestas fieles.
Por lo tanto, si vuestro equipo busca reducir la incertidumbre en entornos corporativos, podéis evaluar cómo enfocar un diseño adecuado para mejorar la precisión de vuestra IA mediante RAG. Además, resulta clave comprender a fondo qué desencadena las anomalías en chatbots y alucinaciones de la IA.
Realidad técnica del fine-tuning
El ajuste fino de pesos (fine-tuning) se utiliza habitualmente para adaptar el estilo, formato o vocabulario técnico a un dominio específico. Sin embargo, no debe presentarse como un método para certificar la ausencia absoluta de sesgos. De hecho, alcanzar dicha meta es inviable en espacios probabilísticos de alta dimensionalidad. Por este motivo, el rigor técnico exige:
- En primer término, auditar con detalle la calidad, representatividad y limpieza del dataset de ajuste.
- Además, ejecutar pruebas automatizadas de regresión. De este modo, es posible monitorizar si el modelo pierde capacidades generales previas (olvido catastrófico).
- Por último, incorporar explicabilidad en aquellas variables operativas críticas mediante metodologías estructuradas de IA explicable para mitigar la caja negra.
Vendor due diligence: qué auditar al contratar un proveedor de IA
A menudo, las soluciones corporativas involucran a proveedores externos de software, plataformas de datos o modelos como servicio. Por tanto, el equipo directivo debe realizar una rigurosa debida diligencia antes de firmar cualquier contrato. En este sentido, la revisión técnica y operativa tiene que responder con claridad a diez áreas críticas:
- Localización geográfica del cómputo: Conviene verificar la región exacta donde se alojan los servidores de inferencia y almacenamiento. De este modo, se garantiza el cumplimiento normativo en las transferencias internacionales de datos.
- Políticas de retención de telemetría: Resulta fundamental aclarar si el proveedor guarda los prompts o las salidas temporales para depuración. Asimismo, debéis exigir el periodo máximo fijado para su purga definitiva.
- Uso de datos para entrenamiento: Se requiere una confirmación contractual explícita. Por consiguiente, vuestros inputs y embeddings jamás deben utilizarse para perfeccionar modelos generales de terceros.
- Cadena de subencargados (sub-processors): Es indispensable identificar a todos los terceros involucrados en la infraestructura cloud. Además, conviene revisar quién opera los servicios de guardrails de seguridad.
- Seguridad física y lógica: Conviene auditar los informes de aseguramiento más relevantes según el proveedor y el contexto. Por ejemplo, destacan certificaciones como ISO/IEC 27001 o informes SOC 2 Type II.
- Control de accesos y cifrado: Debéis comprobar la encriptación de los datos tanto en reposo como en tránsito. Además, es recomendable contar con soporte para claves gestionadas por el cliente (KMS/BYOK) cuando el caso lo justifique.
- Trazabilidad y registro de eventos: La plataforma debe permitir la exportación de logs de acceso y consumo. De esta forma, podréis integrarlos en vuestro propio sistema SIEM para auditorías forenses.
- Garantías de propiedad intelectual: Conviene exigir cláusulas claras de indemnidad legal. Así, vuestra empresa estará protegida si el modelo fundacional recibe demandas por infracción de copyright en su entrenamiento.
- Continuidad operativa y acuerdos de nivel de servicio (SLAs): Debéis pactar garantías sólidas de disponibilidad y latencia. Igualmente, es vital fijar tiempos de respuesta rápidos ante incidencias críticas en planta o back-office.
- Estrategia de salida y portabilidad: Es crucial definir los procedimientos técnicos para extraer embeddings, metadatos y código de integración. En consecuencia, evitaréis bloqueos si ocurre una discontinuidad del modelo o una rescisión contractual.
Cómo calcular el coste real de un proyecto de IA: TCO frente a ROI
Un error común al presupuestar consiste en comparar tecnologías únicamente por el coste por token o la licencia del software. Sin embargo, en proyectos reales de ingeniería de IA, la viabilidad depende de múltiples factores técnicos y organizativos. Por tanto, el Coste Total de Propiedad (TCO) debe abarcar diversas partidas esenciales:
- Infraestructura y cómputo: Supone costes en servidores, consumo de GPUs dedicadas o facturación elástica por llamada API. Además, contempla el escalado de bases vectoriales y el almacenamiento en disco de alta velocidad.
- Ingeniería e integración de datos: Requiere sanear fuentes legadas antes de utilizarlas. Asimismo, implica construir conectores ETL/ELT y orquestar canalizaciones de datos estables.
- Observabilidad y mantenimiento: Incluye monitorizar el drift (deriva de datos y del modelo) junto con guardrails de seguridad contra inyecciones. Por otra parte, exige auditar la calidad de respuesta, el groundedness y reevaluar periódicamente la precisión.
- Cumplimiento y gobernanza: Abarca auditorías de seguridad y asesoría jurídica técnica. Por consiguiente, demanda redactar documentación de conformidad y estructurar planes de contingencia.
- Adopción y gestión del cambio: Demanda capacitar al personal técnico de la organización. En consecuencia, también requiere rediseñar los flujos de trabajo operativos habituales.
Para evitar desvíos en la inversión, conviene calcular el retorno (ROI) mediante métricas de negocio tangibles. Por ejemplo, podéis evaluar la reducción del tiempo de resolución de incidencias mecánicas, las horas ahorradas en redacción de borradores o la detección de defectos. Así pues, resulta arriesgado basar las decisiones en supuestos teóricos genéricos. Además, podéis apoyaros en nuestro desglose detallado sobre cómo analizar el coste de implementar IA y calcular su TCO.
Checklist para CIO/CTO antes de aprobar un proyecto de IA
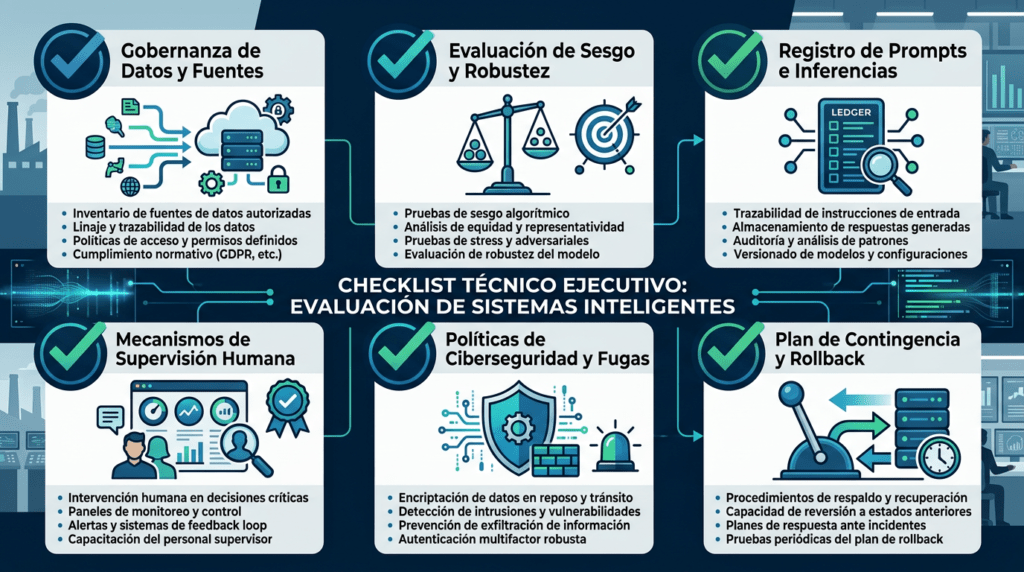
Antes de autorizar horas de ingeniería o firmar contratos comerciales, resulta esencial validar la viabilidad del caso. Por ello, el comité técnico puede apoyarse en este framework decisional de 12 preguntas para garantizar la gobernanza del proyecto:
- Objetivo empresarial: En primer lugar, definid el problema de negocio. ¿Qué cuello de botella resuelve este desarrollo y qué métrica medirá su éxito directo?
- Naturaleza del dato: Asimismo, conviene auditar las fuentes originales. ¿Qué calidad técnica presentan y quién ostenta la titularidad de esa información?
- Presencia de datos personales: Por otra parte, revisad el impacto en privacidad. ¿Tratáis datos de clientes o empleados y disponéis de base legítima bajo el RGPD?
- Propiedad industrial y secreto comercial: Además, analizad la protección intelectual. ¿Intervienen parámetros sujetos a acuerdos de confidencialidad o patentes propias?
- Soberanía y residencia: En este sentido, verificad la infraestructura técnica. ¿En qué región opera la inferencia y qué retención temporal se aplica?
- Selección del proveedor: De igual modo, auditad al suministrador externo. ¿Habéis revisado sus cláusulas de no entrenamiento, sus subencargados y sus certificaciones?
- Rol regulatorio de la empresa: Por tanto, aclarad vuestra posición legal. ¿Actuáis solo como deployer o las adaptaciones os convierten en provider?
- Clasificación de riesgo normativo: Sin duda, el AI Act fija requisitos según el caso. ¿Se encuadra la solución en alto riesgo, transparencia obligatoria o riesgo mínimo?
- Supervisión y control humano: En consecuencia, asegurad la gobernanza operativa. ¿Puede un especialista cualificado auditar, corregir o detener una decisión algorítmica?
- Cálculo exhaustivo de TCO: Igualmente, presupuestad los costes indirectos recurrentes. ¿Habéis computado la observabilidad, el cómputo continuo, las bases vectoriales y el mantenimiento?
- Validación de viabilidad y ROI: Por consiguiente, contrastad el caso frente a soluciones deterministas. ¿Supera el proyecto ese análisis previo? Para profundizar, podéis revisar nuestra comparativa entre automatizaciones vs agentes de IA y la checklist estratégica para invertir en IA.
- Mecanismo de contingencia y desmantelamiento: Finalmente, estableced un protocolo de salida segura. ¿Disponéis de un plan para desconectar el sistema ante desviaciones anómalas sin frenar la operativa básica?
Cómo convertir el cumplimiento en una capacidad de escalado
Abordar la regulación de IA: qué debes tener en cuenta antes de desarrollar un proyecto de IA desde una perspectiva puramente defensiva resulta arriesgado. De hecho, esta postura suele transformar la seguridad y el cumplimiento en un freno para la innovación. En cambio, las organizaciones líderes integran estas exigencias desde la fase inicial de diseño. Por tanto, contar con un catálogo de datos curado, pipelines trazables y accesos transversales permite mitigar riesgos mientras acelera la puesta en producción.
Además, esta base técnica sólida facilita escalar cualquier iniciativa analítica con mayor agilidad. Si vuestra empresa estandariza las auditorías de privacidad y asegura los entornos de ejecución, lanzar nuevos casos de uso requerirá solo una fracción del presupuesto inicial. Por consiguiente, integrar el marco normativo en el código (compliance by design) no detiene el avance. Al contrario, aporta previsibilidad, escalabilidad y solvencia técnica ante auditorías regulatorias y clientes B2B exigentes.
Cómo os acompaña Datipic en el ciclo de vida del proyecto
Por el contrario, construir una solución de inteligencia artificial en producción no consiste en conectar una llamada a un modelo comercial. De hecho, este despliegue requiere un trabajo riguroso de arquitectura de datos, selección algorítmica y ciberseguridad. Asimismo, exige una integración sólida en sistemas ERP/MES/SCADA junto con un gobierno técnico continuado.
Por esta razón, en Datipic no comercializamos herramientas genéricas empaquetadas. Al contrario, actuamos como socio técnico para acompañar a vuestros equipos de IT e innovación en cada etapa:
- Diagnóstico de viabilidad técnica y regulatoria: En primer lugar, evaluamos el caso de uso, el nivel de riesgo y la madurez de los datos en una Fase 0 de viabilidad y estrategia IA.
- Diseño arquitectónico seguro: A continuación, definimos entornos on-premise, cloud privado o híbridos. De este modo, garantizamos un aislamiento estricto de vuestros secretos industriales.
- Ingeniería de datos y RAG avanzado: Posteriormente, implementamos pipelines de procesamiento documental y arquitecturas de recuperación. Además, incorporamos capas robustas de evaluación y observabilidad continua.
- Despliegue, gobernanza y soporte: Por último, integramos mecanismos de supervisión humana (human-in-the-loop) y métricas de TCO bajo nuestra metodología de ingeniería de datos e IA.
Conclusión: validar antes de codificar
El éxito de los proyectos de inteligencia artificial en la empresa no depende de lanzar prototipos con rapidez. Al contrario, reside en la solidez técnica y normativa de la infraestructura subyacente. Por tanto, conviene comprender qué obligaciones impone el AI Act antes de escribir código. Además, es indispensable estructurar la gestión de datos bajo el RGPD y auditar a los proveedores externos.
Asimismo, calcular con rigor el coste total de propiedad (TCO) permite evaluar la viabilidad económica real del despliegue. De este modo, reduciréis la incertidumbre operativa y evitaréis sanciones futuras. En consecuencia, si vuestro equipo planifica un nuevo caso algorítmico o audita una solución en marcha, conviene contar con criterio experto. Por esta razón, podéis dar el siguiente paso técnico y solicitar una sesión de diagnóstico de viabilidad y arquitectura con los especialistas de Datipic, con matices que desarrollamos en convocatorias de subvenciones de IA.