Imaginad una planta de manufactura avanzada con líneas automatizadas funcionando a pleno rendimiento. De forma imprevista, un algoritmo de mantenimiento predictivo emite una parada técnica de urgencia para un centro de mecanizado crítico. Al revisar la consola, los ingenieros de planta solo observan un índice numérico de riesgo: 0,87. El sistema no proporciona el origen del cálculo, las variables que han disparado la alerta ni la pieza en aparente degradación.
En este escenario, el equipo técnico se enfrenta a un dilema complejo: detener la producción e incurrir en costes directos de inactividad o desoír el aviso asumiendo el riesgo de una avería grave. Este fenómeno, característico de los modelos de caja negra , evidencia los límites de implementar algoritmos avanzados sin mecanismos de interpretabilidad contextual. Para los directores de tecnología y responsables de operaciones, comprender el equilibrio entre automatizaciones y agentes de IA permite auditar decisiones delegadas y gestionar el riesgo operacional con mayor control.
Qué es la IA explicable y por qué importa en la empresa
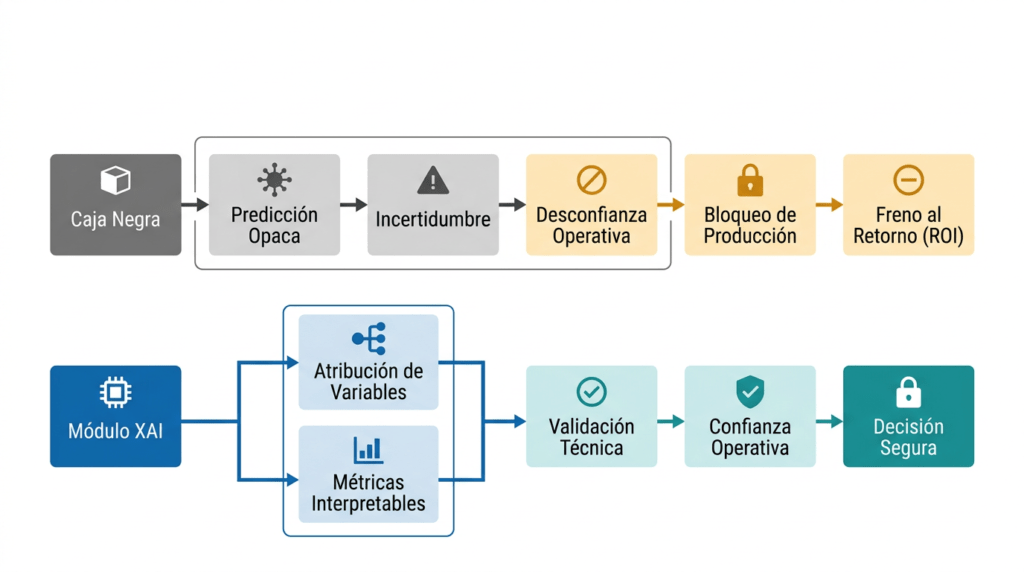
La inteligencia artificial explicable (XAI, por sus siglas en inglés) reúne un conjunto de técnicas, metodologías y criterios de arquitectura que permiten a los equipos humanos comprender, auditar y supervisar los resultados generados por algoritmos de aprendizaje automático. Lejos de ser un debate meramente académico, el interés corporativo en la XAI responde a necesidades directas de viabilidad en producción.
En el entorno empresarial moderno, los sistemas de IA deben equilibrar múltiples compromisos operativos:
- Precisión vs. interpretabilidad: Modelos con arquitecturas complejas pueden ofrecer métricas elevadas en laboratorio, pero resultar inmanejables si el usuario final no comprende sus deducciones.
- Latencia y computación: La generación de explicaciones computacionales requiere tiempo y recursos de cómputo que deben ajustarse a los acuerdos de nivel de servicio (SLA) de cada proceso.
- Mantenibilidad y riesgo de negocio: Un sistema incapaz de justificar fallos incrementa el tiempo de diagnóstico y dificulta la detección de sesgos o desajustes operacionales.
El objetivo de la XAI no es simplificar artificialmente los modelos, sino dotar a las organizaciones de visibilidad suficiente para evaluar la robustez de las predicciones en procesos donde un error conlleva pérdidas económicas o riesgos de seguridad.
Interpretabilidad, explicabilidad, transparencia e IA responsable
Conforme a las directrices de marcos de referencia como el NIST AI Risk Management Framework, es conveniente precisar conceptos que frecuentemente se utilizan como sinónimos en la literatura corporativa:
- Explicabilidad: Según el marco de referencia del NIST, se refiere a la representación de los mecanismos subyacentes al funcionamiento del sistema. Hace posible describir cómo opera un modelo y de qué forma se procesa la información para llegar a una salida determinada.
- Interpretabilidad: Corresponde al significado y comprensión de las salidas del sistema de IA dentro del contexto de su finalidad funcional prevista, permitiendo al usuario contextualizar y ponderar el sentido de la predicción generada.
- Transparencia: Abarca una dimensión organizativa y técnica más amplia. Implica documentar y hacer accesible la información sobre el origen de los datos de entrenamiento, los criterios de curación, el versionado del pipeline, las limitaciones conocidas del sistema y sus mecanismos de gobierno.
- IA responsable: Es el marco de gobernanza global que articula políticas de equidad, mitigación de sesgos, seguridad de la información, robustez, privacidad y cumplimiento legal conforme a normativas de referencia como el AI Act de la Unión Europea en todo el ciclo de vida del dato.
Comprender estas diferencias permite a los comités de innovación determinar con rigor qué dimensión técnica requiere cada proyecto, sin exigir explicabilidad algorítmica donde lo necesario es simplemente una mejor higiene y trazabilidad de los datos.
¿Cuándo necesita una empresa XAI?
No todos los casos de uso justifican el coste computacional ni la complejidad de integrar capas adicionales de explicación. La necesidad de incorporar XAI está ligada al nivel de riesgo del caso de uso, el impacto de una decisión incorrecta y la presencia de supervisión humana cualificada.
A continuación se presenta una matriz orientativa para evaluar esta necesidad según el contexto operativo:
|
Caso de uso |
Nivel de riesgo | Requisito de explicabilidad | Tipo de explicación recomendada |
|---|---|---|---|
| Mantenimiento predictivo crítico | Alto | Crítico | Local: Desglose de variables sensorizadas relevantes y evolución temporal de la anomalía. |
| Control de calidad no destructivo | Medio – Alto | Alto | Visual: Mapas de activación de frecuencia o segmentación de áreas defectuosas. |
| Previsión de demanda (Forecasting) | Medio | Moderado | Global: Importancia agregada de factores estacionales, precios y stock. |
| Clasificación interna de documentos | Bajo | Opcional / Mínimo | Trazabilidad de metadatos y confianza de extracción básica. |
| Motores de recomendación interna | Bajo | Bajo |
Reglas de asociación simples y heurísticas de similitud. |
Como demuestra la matriz, la decisión debe supeditarse a las consecuencias operativas de un falso positivo o un falso negativo en el negocio.
Tipos de explicaciones en sistemas de IA
Los métodos de explicabilidad resuelven preguntas técnicas de diversa naturaleza según el momento y la persona que consulta el sistema:
- Explicaciones globales: Proporcionan una visión del comportamiento general del modelo en todo el dominio de datos. Permiten a los científicos de datos validar qué variables tienen mayor peso estadístico medio. datos de vuestra organización.
- Explicaciones locales: Se centran en una única inferencia específica. Detallan exactamente qué entradas particulares influyeron para clasificar una muestra determinada en una categoría concreta.
- Feature Importance (Importancia de características): Identifica y califica el peso relativo de cada variable en el resultado. Resulta habitual en modelos estructurados basados en datos tabulares.
- Explicaciones contrafactuales: Describen cuál sería la alteración mínima necesaria en las variables de entrada para que la decisión del modelo cambie de signo (por ejemplo: «si una variable hubiera tomado un valor diferente dentro de un rango físicamente plausible, la alerta no se habría activado»).
- Visualización de señales: En procesamiento de señales industriales y visión artificial, traduce matrices complejas en mapas de calor (heatmaps) o espectrogramas comprensibles.
SHAP, LIME y otras técnicas: capacidades y limitaciones reales
Herramientas como SHAP (Shapley Additive exPlanations) y LIME (Local Interpretable Model-agnostic Explanations) son referentes en el análisis post-hoc de modelos. Sin embargo, su integración en arquitecturas empresariales exige entender sus supuestos matemáticos: coste de implementar IA en la empresa.
- Aproximaciones estadísticas: Estos marcos no revelan la verdad causal de un proceso físico; estiman contribuciones marginales de variables basándose en perturbaciones de datos o teoría de juegos cooperativos.
- Correlación no es causalidad: Una variable puede recibir una alta puntuación de contribución sin ser la causa raíz del fallo técnico si existe colinealidad o fuga de datos (data leakage).
- Sobrecarga computacional: Métodos como KernelSHAP pueden requerir numerosas evaluaciones del modelo original para explicar una inferencia, lo que puede incrementar significativamente el coste computacional y resultar inviable en entornos de baja latencia o inferencia en el edge sin optimizaciones previas.
Por consiguiente, las explicaciones post-hoc deben ser validadas periódicamente y no sustituyen una rigurosa fase de ingeniería de características ni la supervisión de expertos de dominio.
Caso práctico: detección de anomalías acústicas en la industria
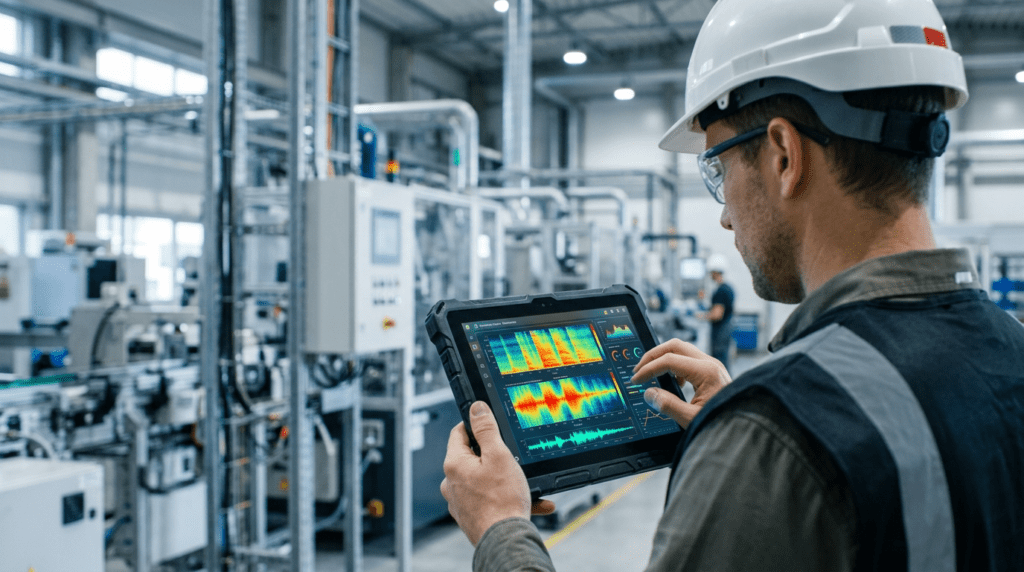
En Datipic abordamos la inspección técnica de maquinaria compleja mediante análisis de audio industrial. En nuestro proyecto de detección de anomalías en audio industrial con Deep Learning, el objetivo radica en identificar desajustes mecánicos a partir de patrones sonoros continuos.
Desde el punto de vista arquitectónico, una red convolucional o un autoencoder puede procesar representaciones espectrales para clasificar una señal como defectuosa. No obstante, si el sistema se limita a emitir una señal binaria de anomalía, el operario de mantenimiento se encuentra ante un vacío operativo. ¿Se trata de un fallo de lubricación, una fisura en el eje o una interferencia acústica externa en la nave?
Una arquitectura equipada con una capa de explicabilidad complementa la inferencia profunda de la siguiente forma:
- Aislamiento de bandas de frecuencia: El sistema resalta las regiones del espectrograma que han contribuido anomalamente a elevar el índice de error de reconstrucción.
- Correlación temporal: Muestra en qué milisegundo exacto del ciclo de rotación se produce la desviación acústica, facilitando su contraste con la posición angular del eje mecánico.
- Soporte al técnico especialista: El operario contrasta la evidencia visual acústica con su experiencia directa en planta antes de decidir si paraliza la línea o programa una revisión de turno.
Este planteamiento aporta contexto adicional para reducir la incertidumbre operativa y fomenta la adopción de los sistemas inteligentes en entornos operativos de alta exigencia.
Cómo diseñar una arquitectura preparada para la explicabilidad
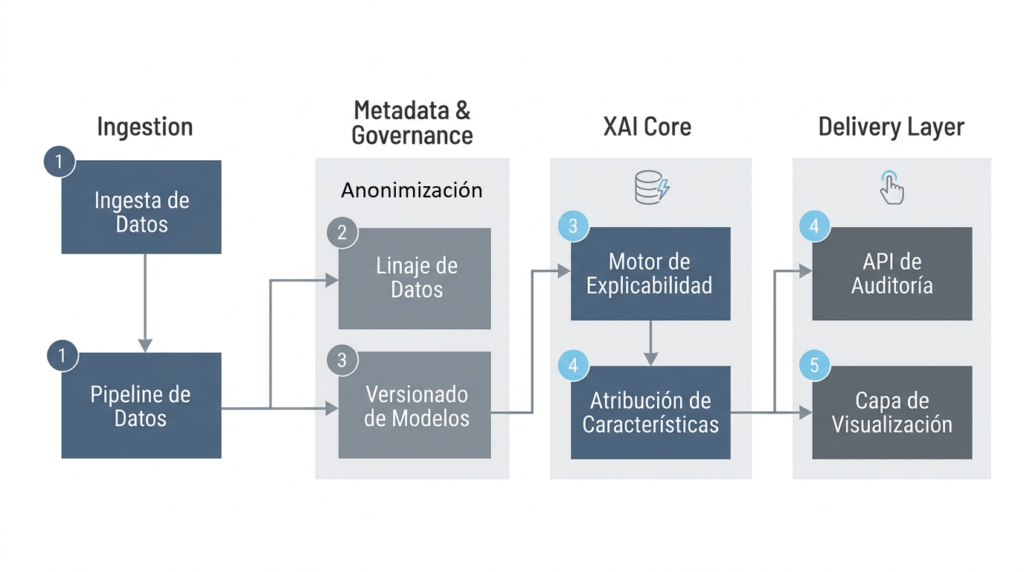
La explicabilidad no debe implementarse como un módulo cosmético adherido al cierre de un proyecto. Para que resulte funcional y mantenible, debe estructurarse a lo largo del pipeline de datos e inferencia:
- Ingesta y gobierno de datos: Validación de esquemas y registro de calidad de origen. Si los datos iniciales presentan sesgos no detectados, las explicaciones subsiguientes carecerán de fiabilidad operativa.
- Ingeniería de variables y trazabilidad: Registro de transformaciones matemáticas aplicadas a las señales o registros brutos.
- Inferencia del modelo: Ejecución del algoritmo principal de predicción o clasificación.
- Capa de explicabilidad selectiva: Generación de métricas de atribución (locales o globales) calculadas únicamente para inferencias dudosas o eventos críticos, optimizando los recursos de cómputo.
- Capa de servicio y presentación: Distribución de la información según el perfil de consumo.
- Auditoría y logging centralizado: Almacenamiento conjunto de la predicción, la explicación calculada y el contexto del sistema para inspecciones futuras.
El factor humano: la explicación según el perfil del usuario
Un error frecuente consiste en diseñar interfaces uniformes. La utilidad de una explicación varía radicalmente según la función de quien la interpreta: proyectos tecnológicos.
- Operario de planta: Requiere respuestas ejecutivas: qué componente muestra riesgo, en qué zona y qué acción preventiva inmediata se sugiere.
- Equipo técnico y científicos de datos: Precisan métricas detalladas de atribución local, curvas de calibración y análisis de gradientes para depurar el modelo.
- Dirección y comités de cumplimiento: Exigen evidencias auditables sobre la mitigación de sesgos, la seguridad operacional y la alineación con marcos regulatorios exigentes.
La inteligencia artificial explicable transforma la desconfianza técnica en una ventaja operativa medible. Al sustituir la opacidad de los algoritmos de caja negra por arquitecturas transparentes y trazables, las organizaciones reducen riesgos de inactividad, aseguran el cumplimiento normativo y aceleran el retorno de inversión en sus iniciativas tecnológicas.
Si queréis evaluar cómo integrar modelos explicables y auditables en vuestros procesos industriales o de negocio, podéis solicitar una sesión estratégica con nuestro equipo de consultores e ingenieros en IA.