En una planta de manufactura avanzada o en una organización con flujos intensivos de datos, la decisión de infraestructura rara vez perdona los planteamientos simplistas. Un patrón habitual se repite en el tejido corporativo: tras migrar sistemáticamente servicios a la nube pública bajo la promesa de agilidad operativa y reducción de mantenimiento, los costes recurrentes por transferencia de salida (data egress fees) se disparan y las oscilaciones en la latencia de red provocan microparadas imprevistas en los sistemas de control de planta.
Este escenario evidencia que abordar la disyuntiva de Cloud vs On-Premise: cómo decidir qué infraestructura necesita tu empresa no es un debate tecnológico sobre preferencias de plataforma, sino un ejercicio de cálculo financiero, análisis de arquitectura de datos y gestión de riesgos operativos. Ninguna infraestructura resulta óptima de forma universal; cada carga de trabajo (workload) presenta exigencias divergentes de rendimiento, gobernanza y coste. Antes de iniciar despliegues, conviene analizar las diferencias operativas entre automatizaciones y agentes de IA para dimensionar correctamente los recursos de cómputo. coste total de propiedad.
Para directores de tecnología (CTO), responsables de sistemas (CIO) y directores de operaciones, resolver esta ecuación requiere evaluar con rigor el coste total de propiedad (TCO), las dependencias de red, la tolerancia a la indisponibilidad y los requisitos de cumplimiento normativo antes de comprometer inversiones de capital o suscribir contratos plurianuales con proveedores cloud.
Qué se decide realmente al evaluar infraestructuras empresariales
Hoy en día, el debate supera el antagonismo binario entre el centro de datos local y la nube pública. En realidad, la infraestructura moderna se define por la distribución estratégica de las cargas de trabajo. Además, decidir dónde procesar y almacenar la información exige equilibrar la elasticidad técnica con el control directo de los recursos.
Al contratar servicios en la nube, vuestra empresa delega el hardware físico, la virtualización y la redundancia eléctrica en un tercero especializado. Sin embargo, esta opción introduce dependencias en conectividad WAN y tarifas variables por uso. Asimismo, quedáis sujetos a las políticas de servicio de dicho proveedor. Por el contrario, operar infraestructura en instalaciones propias garantiza un control total del entorno. No obstante, este modelo exige asumir íntegramente la inversión de capital inicial y el mantenimiento técnico. Por tanto, deberéis gestionar directamente la refrigeración, la seguridad física y la amortización del equipamiento.
En consecuencia, el comité técnico no debe limitarse a elegir un bando tecnológico rígido. Su verdadero reto consiste en identificar qué procesos requieren inmediatez física o soberanía operativa. De igual forma, conviene definir cuáles obtienen rentabilidad real al aprovechar la elasticidad de entornos gestionados. Por esta razón, antes de abordar transformaciones complejas, conviene analizar el retorno previsto. Para ello, podéis revisar una guía estructurada para evaluar proyectos tecnológicos con impacto directo en la cuenta de resultados.
El espectro de arquitecturas: Public Cloud, Private Cloud, On-Premise, Edge e Híbrida
Para fundamentar una decisión corporativa con precisión técnica, resulta imprescindible diferenciar las cinco modalidades arquitectónicas existentes. Por tanto, conviene evitar equiparar la nube únicamente con entornos públicos. Del mismo modo, no se debe confundir el despliegue local con la computación perimetral:
- Public Cloud: Es una infraestructura multinquilino gestionada por hiperescaladores. En este modelo, los recursos de computación y almacenamiento se consumen bajo demanda. Además, ofrece una elevada elasticidad horizontal y un amplio catálogo de servicios gestionados.
- Private Cloud: Consiste en una plataforma cloud dedicada de forma exclusiva a una única organización. Puede alojarse en instalaciones locales o en un centro de datos externo. Por consiguiente, ofrece automatización y aprovisionamiento elástico, pero manteniendo un aislamiento estricto de los recursos.
- On-Premise clásico: Emplea servidores dedicados y sistemas de almacenamiento situados dentro de las instalaciones propias. Además, este entorno lo administra personal interno mediante arquitecturas de virtualización tradicionales.
- Edge Computing: Integra nodos de computación descentralizados cerca de donde se generan los datos, como maquinaria industrial, terminales de visión artificial o sensores IoT. Por ello, procesa la información de forma local y minimiza la dependencia del enlace WAN.
- Hybrid Cloud: Es una arquitectura integrada que orquesta cargas de trabajo en múltiples entornos. Así, combina nube pública o privada con infraestructura local y nodos Edge. Como resultado, garantiza la interoperabilidad y facilita el trasvase de datos según las necesidades de cada proceso.
Desglose del coste real: por qué el TCO no equivale al ROI
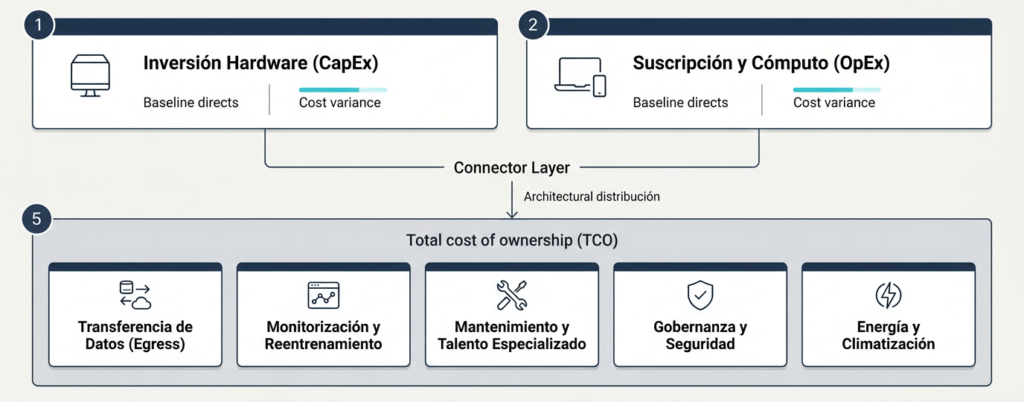
Un error persistente en la planificación tecnológica es confundir el TCO (Total Cost of Ownership) con el ROI (Return on Investment). Por un lado, el TCO cuantifica el coste integral de aprovisionar, operar, mantener y retirar una infraestructura. Por otro lado, el ROI mide el retorno económico neto generado por las aplicaciones de negocio.
Por tanto, una arquitectura puede mostrar un TCO reducido y fracasar al no aportar la velocidad requerida. Del mismo modo, una infraestructura con un TCO elevado resulta rentable si desbloquea nuevas fuentes de ingresos. Por consiguiente, para calcular el TCO con precisión técnica, debéis desglosar las siguientes partidas tanto en CapEx como en OpEx:
Costes en infraestructura local y perimetral (CapEx intensivo)
- Adquisición de hardware: Incluye servidores, aceleradores gráficos (GPU), cabinas SAN/NAS y switches de red.
- Costes de instalaciones e indirectos: Abarca el consumo eléctrico, sistemas de alimentación ininterrumpida (SAI/UPS), climatización y espacio en planta.
- Operación y talento especializado: Contempla los salarios de ingenieros de sistemas, técnicos de redes y especialistas en ciberseguridad.
- Mantenimiento y garantías: Además, exige contratos de soporte oficial, recambios y renovaciones de hardware cada tres o cinco años.
- Continuidad y licencias: Requiere licencias de virtualización, copias de seguridad locales y replicación ante desastres.
Costes en infraestructura cloud (OpEx variable)
- Cómputo y almacenamiento: Comprende instancias bajo demanda o reservadas, almacenamiento por bloques y depósitos de objetos.
- Transferencia de salida (Egress fees): Supone un coste por gigabyte saliente hacia Internet, factor a menudo imprevisto.
- Servicios gestionados y licencias PaaS: Asimismo, incluye bases de datos administradas, clústeres de orquestación y balanceadores de carga.
- Observabilidad y seguridad: Integra herramientas de registro centralizado, métricas de telemetría, gestión de secretos y cortafuegos avanzados.
- Costes de migración y desvinculación: Por último, abarca la modernización de código, ajuste de canalizaciones y una eventual salida de la nube.
Gobernanza, soberanía del dato y mitigación de latencias críticas
La ubicación física de la infraestructura técnica determina directamente dos variables sensibles para cualquier comité de dirección. Por un lado, define la latencia operativa; por otro, marca el marco de gobernanza aplicable a la información corporativa.
Soberanía, residencia y cumplimiento regulatorio
A menudo se comete la imprecisión de equiparar la soberanía del dato con la residencia física o la mera localización de los servidores. Sin embargo, ambos conceptos son distintos. En términos técnicos y jurídicos rigurosos, la residencia del dato hace referencia a la ubicación geográfica donde se almacenan y procesan físicamente los bits. Por su parte, la soberanía jurídica de los datos no depende únicamente de dónde estén físicamente los servidores.
De hecho, estas exigencias normativas dependen de la jurisdicción aplicable, como el RGPD europeo. Además, varían según el sector regulado (farmacéutico, financiero, defensa o infraestructuras críticas) y los mecanismos de transferencia internacional. Por consiguiente, no existen axiomas universales.
Asimismo, los principales proveedores de nube pública disponen de regiones, controles y certificaciones específicas. Estas capacidades facilitan el cumplimiento de determinados requisitos normativos. No obstante, dicho cumplimiento debe evaluarse en función de cada caso de uso, configuración técnica y modelo de responsabilidades compartidas. Por esta razón, antes de desplegar modelos analíticos o de IA, resulta prudente evaluar las directrices legales en materia de regulación y gobernanza de proyectos de IA.
Desmitificando la latencia en entornos industriales
En procesos de producción continua, robótica colaborativa o inspección automática de calidad, cada milisegundo cuenta. De hecho, una pequeña demora marca la diferencia entre una operación estable y una parada de línea costosa. Por lo tanto, resulta indispensable desagregar los componentes que forman el retardo total:
- Latencia de red (WAN): Es el tiempo de tránsito de los paquetes hacia la nube a través de enlaces externos. Este retardo está condicionado por la distancia física, el enrutamiento de los operadores y las posibles fluctuaciones de tráfico.
- Tiempo de procesamiento e inferencia: Representa la duración del cómputo en CPU o GPU. Durante este intervalo, el sistema ejecuta el algoritmo de analítica o el modelo matemático correspondiente.
- Latencia del ciclo industrial: Es la ventana de tiempo máxima tolerada por los autómatas programables (PLC) o sistemas SCADA. Si no reciben la orden de actuación dentro de este margen, abortan el ciclo por seguridad.
Por un lado, desplegar servidores locales o dispositivos de Edge Computing en la propia planta reduce drásticamente el retardo de transmisión WAN. Además, esta arquitectura mitiga la vulnerabilidad ante cortes del enlace a Internet. Sin embargo, no elimina el tiempo de procesamiento intrínseco del hardware. Por tanto, tampoco garantiza inmunidad si el software de captura presenta cuellos de botella.
Seguridad perimetral, autorización delegada y el modelo Zero Trust
La protección de la infraestructura corporativa ya no puede fundamentarse en premisas obsoletas. Durante años, por ejemplo, se asumió que todo elemento dentro del perímetro de la red local era fiable. Sin embargo, el entorno exterior siempre representaba una amenaza constante. Además, la proliferación de dispositivos industriales conectados y vectores de ataque avanzados ha invalidado por completo esta concepción tradicional.
Por esta razón, el marco de referencia contemporáneo es la arquitectura Zero Trust (Confianza Cero). Este estándar ha sido respaldado por organismos como el Instituto Nacional de Estándares y Tecnología de EE. UU. (NIST SP 800-207). Asimismo, este paradigma parte de un principio estricto: la ubicación en la red jamás concede privilegios implícitos. Por consiguiente, ningún usuario, dispositivo o servicio interno se considera seguro por defecto.
Este enfoque resulta indispensable para proteger la soberanía de la información sensible en cualquier entorno. De igual modo, garantiza la precisión de las respuestas dentro del ecosistema digital de vuestra organización. Por tanto, bajo este modelo técnico, es fundamental diferenciar con claridad los mecanismos de acceso y de identidad:
- OAuth 2.0 y OpenID Connect (OIDC): En primer lugar, OAuth 2.0 es un marco estándar de autorización delegada. Su diseño permite conceder acceso a recursos específicos sin necesidad de compartir credenciales. Por su parte, la autenticación de identidad se implementa mediante capas construidas sobre él, principalmente OpenID Connect (OIDC). Este protocolo añade tokens de identidad verificables y seguros.
- Identity-Aware Proxy (IAP): En segundo lugar, las soluciones basadas en contexto y proxies de aplicación validan la identidad del usuario en tiempo real. Además, examinan el estado del dispositivo y las políticas de acceso antes de autorizar cualquier petición. De este modo, facilitan el acceso a aplicaciones internas sin necesidad de exponer redes VPN tradicionales.
No obstante, implementar un proxy de identidad o protocolos modernos de autorización no resuelve la seguridad por sí solo. En realidad, constituye un componente dentro de una estrategia integral de defensa. Por consiguiente, vuestra empresa debe incorporar segmentación de red interna y cifrado en tránsito y en reposo. Asimismo, resulta esencial aplicar una gestión continua de parches y una monitorización exhaustiva de anomalías.
Continuidad de negocio y riesgo de dependencia (Lock-in)
Toda evaluación técnica debe responder con objetividad a dos contingencias críticas. En primer lugar, debéis analizar qué ocurre cuando los componentes fallan. Asimismo, resulta vital calcular qué coste representaría trasladar los sistemas en el futuro.
Disponibilidad, RTO y RPO en operaciones industriales
La resiliencia operativa se mide mediante dos parámetros cuantitativos:
- RTO (Recovery Time Objective): Es el tiempo máximo admisible desde una interrupción del servicio hasta que los sistemas recuperan la operatividad normal.
- RPO (Recovery Point Objective): Representa el volumen máximo de datos, medido en tiempo, que la organización puede permitirse perder entre la última copia de seguridad y el incidente.
Por tanto, la elección de infraestructura debe anticipar escenarios de degradación operativa. Por ejemplo, conviene prever qué ocurre ante un corte de fibra óptica que desconecte la planta de la nube pública. De igual modo, debéis evaluar cómo responde la instalación si falla la fuente de alimentación redundante de un servidor local. En consecuencia, disponer de un modo degradado local (offline-first) en nodos Edge resulta esencial. Gracias a esta arquitectura, mantendréis la línea en funcionamiento continuo mientras se restablece el enlace principal.
Dependencia del proveedor (Vendor Lock-in) y portabilidad
Sin embargo, el coste real de una arquitectura no se agota en las facturas mensuales de cómputo. Este presupuesto también incluye el coste de salida en caso de requerir un cambio de proveedor o una repatriación. Por un lado, utilizar servicios fuertemente acoplados a APIs propietarias abarata los tiempos iniciales de desarrollo. No obstante, esta práctica incrementa de manera sustancial la fricción durante una migración técnica posterior.
Por este motivo, conviene diseñar sobre contenedores estándar (como OCI/Docker), orquestadores portables y protocolos abiertos. De esta manera, podréis preservar la interoperabilidad y negociar con mayor margen frente a los proveedores tecnológicos.
Metodología de decisión: proceso estructurado en 12 pasos
Para determinar qué arquitectura desplegar sin cuellos de botella, conviene evitar el sobredimensionamiento. Por tanto, recomendamos seguir este flujo estructurado en doce pasos:
- Identificar la carga de trabajo: En primer lugar, conviene delimitar la naturaleza del proceso. Así, podréis distinguir entre flujos transaccionales, analítica batch, inferencia en tiempo real o archivado.
- Medir la latencia necesaria: A continuación, cuantificad la ventana máxima admisible. Este margen mide el tiempo entre la captura del dato y la ejecución de la acción.
- Clasificar los datos y gobernanza: Asimismo, resulta vital identificar los requisitos contractuales. Por consiguiente, debéis revisar la propiedad intelectual y el marco regulatorio vigente.
- Determinar volumen y patrón de demanda: Además, analizad el comportamiento del tráfico. Evaluad si es constante y predecible o si presenta picos estacionales acusados.
- Evaluar la elasticidad requerida: Por otra parte, examinad la capacidad de respuesta del sistema. Verificad si la carga exige aprovisionar recursos masivos de forma instantánea.
- Calcular el TCO completo: Después, desglosad todas las partidas directas e indirectas a tres y cinco años. De este modo, compararéis CapEx y OpEx de forma rigurosa.
- Evaluar seguridad y continuidad operativa: También debéis definir objetivos precisos de RTO y RPO. En consecuencia, dispondréis de contingencias fiables si cae el enlace WAN.
- Evaluar capacidades internas del equipo: Sin embargo, la infraestructura requiere talento para gestionarla. Por tanto, medid la disponibilidad interna en redes, virtualización y hardware físico.
- Analizar el grado de acoplamiento (lock-in): Igualmente, conviene estimar la dependencia técnica de cada proveedor. Valorad el impacto económico si debéis afrontar una migración futura.
- Comparar alternativas de despliegue: Por su parte, contrastad cada requisito con las arquitecturas disponibles. Así evaluaréis opciones en Cloud, On-Premise, Edge o modelos híbridos.
- Ejecutar una prueba de concepto (PoC): Luego, poned a prueba la solución técnica en un entorno práctico. De esta forma, validaréis latencia, costes de transferencia y estabilidad real.
- Monitorizar resultados en producción: Finalmente, verificad el rendimiento en el día a día. Así mediréis el ROI efectivo y optimizaréis los recursos consumidos.
Matriz de decisión de infraestructuras empresariales
A continuación, la siguiente matriz sintetiza cómo responde cada modelo ante las exigencias operativas y financieras habituales en entornos corporativos:
|
Criterio de evaluación |
Public Cloud |
On-Premise |
Edge Computing |
Arquitectura Híbrida |
|---|---|---|---|---|
|
Elasticidad y escalabilidad |
Es muy alta e inmediata. Además, permite un aprovisionamiento horizontal bajo demanda. |
Resulta limitada, ya que está sujeta a compra, instalación y configuración de nuevo hardware. Asimismo, conviene vigilar vulnerabilidades técnicas e inyecciones. |
Es muy baja, porque se dimensiona de forma fija para tareas perimetrales específicas. |
Es alta. Por tanto, permite absorber picos en la nube manteniendo cargas base en local. |
|
Latencia de red |
Es variable, pues está condicionada por la calidad del enlace WAN y la distancia al CPD. |
Resulta baja y predecible dentro de la red corporativa local (LAN). |
Es muy baja si el cómputo se realiza junto a la fuente. No obstante, la latencia real depende del hardware, la red y la carga. |
Está optimizada. De este modo, ofrece respuesta perimetral inmediata y consolidación diferida en cloud. |
|
Dependencia de conectividad WAN |
Es alta, porque muchas cargas dependen de la red WAN. Sin embargo, puede mitigarse mediante redundancia, caché o procesamiento local. |
Es baja para cargas locales. No obstante, puede existir dependencia de servicios externos según la arquitectura. |
Resulta mínima, dado que está diseñado para el procesamiento autónomo y la operación sin conexión. |
Es resiliente. Por consiguiente, los procesos críticos operan localmente si cae la conexión remota. |
|
Control físico del activo |
Es nulo, porque el hardware, la seguridad física y el CPD se delegan en el proveedor. |
Es total. Por tanto, garantiza la custodia completa de discos, servidores y perímetro físico. |
Es alto aunque distribuido. Por ello, requiere medidas de protección en planta o dispositivos remotos. |
Está segmentado. Así, combina el control directo de nodos propios con la delegación en servicios externos. |
|
Estructura financiera dominante |
Predomina el OpEx continuo y variable. Además, la facturación es granular según el consumo de recursos. |
Exige un CapEx inicial intensivo, junto con costes de amortización, soporte y ciclo de vida. |
Requiere CapEx inicial en dispositivos. Asimismo, implica un mantenimiento preventivo distribuido. |
Presenta un modelo mixto. En consecuencia, une la amortización de la base con un OpEx elástico para picos. |
|
Carga operativa del equipo interno |
Es media-baja en infraestructura física. Sin embargo, resulta alta en gobierno, FinOps y arquitectura cloud. |
Es muy alta, ya que exige la gestión integral de hardware, redes, refrigeración, parches y copias. |
Se sitúa en un nivel medio-alto, porque exige herramientas de despliegue remoto y monitorización de flotas. |
Es media-alta. Por tanto, requiere perfiles polivalentes que dominen tanto sistemas como entornos cloud. |
|
Idoneidad para cargas continuas |
Puede ser costosa si el uso resulta predecible y continuo al 100% durante varios años. |
Resulta económicamente eficiente para cargas predecibles con alta utilización de cómputo. |
Es óptima para procesar señales y telemetría in situ. Por consiguiente, evita saturar los enlaces WAN. |
Ofrece una opción equilibrada. De este modo, minimiza costes al situar la computación continua donde sea más eficiente. |
Tres escenarios prácticos de arquitectura en la industria
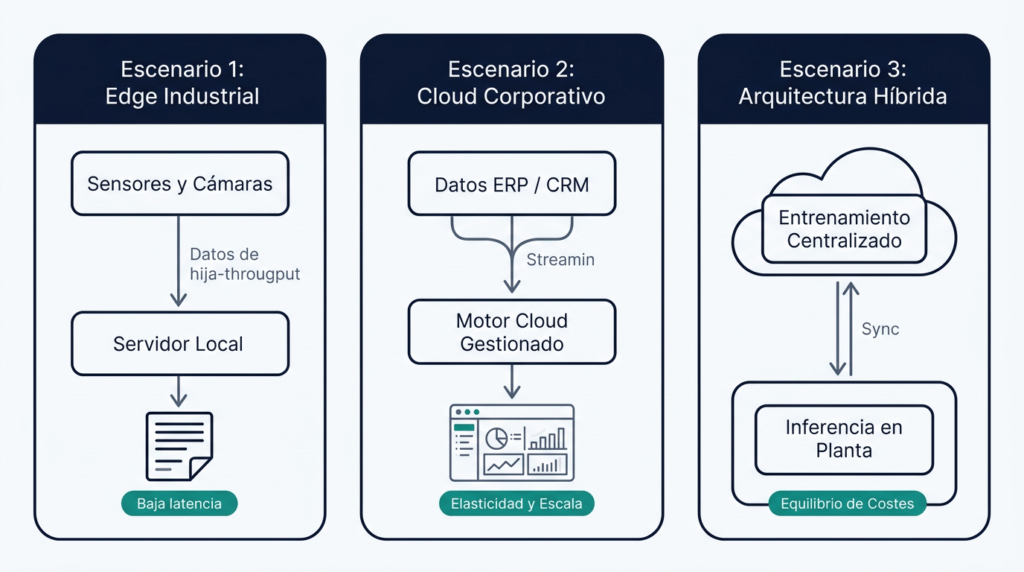
Para tomar una decisión acertada, conviene analizar cómo se articulan estos principios en entornos productivos reales. Por ello, examinamos tres escenarios operativos concretos que ilustran la conveniencia de cada arquitectura:
Escenario 1: Visión artificial e inspección de calidad en línea de fabricación
- Características del workload: Flujo continuo de vídeo en alta resolución a 60 fotogramas por segundo. Su objetivo principal es detectar defectos superficiales en tiempo real.
- Requisito dominante: Latencia determinista ultra reducida, inferior a 20 ms. Por tanto, exige minimizar cualquier dependencia del enlace externo a Internet.
- Arquitectura recomendada: Edge Computing con aceleración por hardware en la propia planta.
- Por qué: Enviar flujos masivos de vídeo a la nube colapsaría el ancho de banda WAN. Además, generaría costes inasumibles de transferencia. Por último, cualquier fallo de red provocaría paradas imprevistas en la producción.
- Riesgos principales: Condiciones ambientales adversas en planta, como polvo o variaciones térmicas. Asimismo, destaca la complejidad de gestionar las actualizaciones de modelos de forma centralizada.
- Qué validar en PoC: Latencia real de inferencia bajo carga máxima de línea. Además, se debe verificar la estabilidad de los mecanismos de actualización OTA (over-the-air).
Escenario 2: Analítica corporativa y cuadro de mando directivo multisede
- Características del workload: Consolidación periódica de datos de ventas, logística y finanzas. Toda esta información proviene de múltiples filiales y sistemas ERP dispersos.
- Requisito dominante: Elasticidad para consultas analíticas complejas. Por consiguiente, requiere agregación global de datos y soporte para accesos concurrentes desde diversas ubicaciones.
- Arquitectura recomendada: Public Cloud mediante un data warehouse o lakehouse gestionado.
- Por qué: Los datos se generan en distintas geografías. Sin embargo, el cómputo analítico presenta picos puntuales de procesamiento. Por este motivo, resulta muy rentable apagar los recursos ociosos cuando no se ejecutan consultas.
- Riesgos principales: Descontrol del gasto mensual por consultas no optimizadas. Igualmente, pueden surgir costes imprevistos durante la ingesta continua de información.
- Qué validar en PoC: Rendimiento del motor analítico ante volúmenes representativos. Por tanto, conviene realizar una simulación rigurosa del coste mensual según el uso proyectado.
Escenario 3: Gemelo digital y optimización de planta de proceso continuo
- Características del workload: Telemetría masiva procedente de sensores industriales. En este caso, el sistema exige control local y simulación predictiva a largo plazo.
- Requisito dominante: Doble necesidad operativa. Por un lado, requiere respuesta inmediata ante anomalías; por otro, demanda entrenamiento periódico de modelos complejos.
- Arquitectura recomendada: Arquitectura Híbrida (Edge para adquisición y control; Cloud para entrenamiento de modelos y analítica pesada).
- Por qué: Esta opción permite procesar y filtrar eventos críticos a pie de máquina. Además, los datos agregados alimentan modelos avanzados de gemelos digitales industriales en entornos elásticos de cómputo.
- Riesgos principales: Complejidad en la configuración de la red. Por consiguiente, se debe garantizar una sincronización segura y bidireccional entre la planta y la nube.
- Qué validar en PoC: Protocolos de compresión y cifrado de telemetría en tiempo real. Asimismo, debe evaluarse la fiabilidad de la orquestación distribuida de cargas.
Cómo valida Datipic la arquitectura técnica antes de invertir
Comprometer inversiones de capital o firmar contratos plurianuales de nube sin verificar su comportamiento en condiciones reales representa un riesgo operativo innecesario. Por ello, desde Datipic aplicamos un enfoque metódico. De esta manera, aseguramos que cada decisión tecnológica responda a un retorno medible y a una estabilidad contrastada:
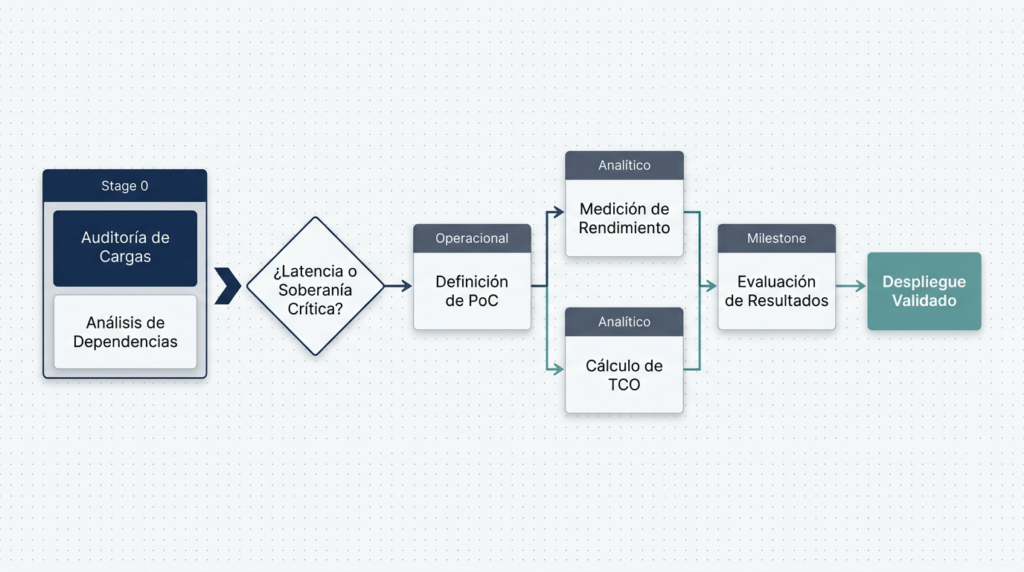
- Diagnóstico de viabilidad técnica (Fase 0): En primer lugar, analizamos la topología de red existente e inventariamos los flujos de información. Además, evaluamos si los datos de vuestra empresa están preparados para la arquitectura objetivo.
- Cálculo integral del TCO: A continuación, proyectamos los costes reales a tres y cinco años. Por consiguiente, contemplamos factores como licencias, consumo energético, personal operativo y costes de transferencia de salida.
- Prueba de concepto en entorno controlado (PoC): Asimismo, diseñamos pilotos con datos y cargas reales. De este modo, medimos de forma empírica la latencia, el consumo de cómputo y la tolerancia a caídas de red antes de escalar.
- Implementación y gobierno (Fase 1): Finalmente, desplegamos soluciones robustas de inteligencia artificial industrial. Garantizamos así observabilidad continua, seguridad Zero Trust y portabilidad de los componentes críticos.
Evaluación de arquitectura Cloud, On-Premise o híbrida
Vuestra organización puede encontrarse en pleno proceso de modernización de infraestructura. Además, quizá estéis evaluando la migración de cargas críticas hacia la nube. Por tanto, definir la plataforma idónea para proyectos de datos e inteligencia artificial resulta clave. En este contexto, nuestro equipo técnico puede acompañaros en el diseño y en la validación del modelo más adecuado.
Por esta razón, a través de una sesión de evaluación de arquitectura técnica obtendréis:
- Análisis técnico de vuestros workloads y dependencias operativas actuales.
- Identificación precisa de requisitos de latencia, soberanía y gobernanza del dato.
- Comparativa objetiva de costes proyectados entre Cloud, On-Premise y esquemas híbridos.
- Definición del alcance de una prueba de concepto para mitigar riesgos antes del despliegue en producción.
Asimismo, podéis solicitar una sesión técnica inicial a través de nuestro formulario de contacto con el equipo de especialistas de Datipic.