Tener miles de millones de registros no significa que vuestra empresa esté preparada para un proyecto de IA. La creencia de que almacenar un volumen masivo de información garantiza el éxito de la inteligencia artificial es una de las principales causas de fricción, sobrecostes (para habrá que ser conocedor sobre cuál es el coste de implementar IA empresarial) y retrasos técnicos en los proyectos de innovación digital.
El problema no es descubrir que vuestros datos necesitan trabajo. El problema es descubrirlo después de haber invertido 30.000 €, 50.000 € o seis meses en desarrollar el proyecto.
Antes de seleccionar modelos de lenguaje, comparar proveedores o diseñar algoritmos, la primera pregunta que debéis plantearos como directivos de tecnología es si realmente contáis con los datos preparados para un proyecto de IA. La preparación real nunca es un estado absoluto de la organización: depende por completo del caso de uso concreto que queráis resolver. No necesitáis una infraestructura perfecta en toda la empresa, sino las fuentes adecuadas para vuestro objetivo actual.
En este artículo os proporcionamos un método práctico de autodiagnóstico para evaluar vuestro ecosistema de datos antes de comprometer recursos y desarrollo.
Idea clave: Una empresa no necesita tener todos sus datos preparados para la IA. Necesita saber si tiene preparados los datos que necesita para el caso de uso que quiere resolver.
Resumen rápido: tus datos para IA están listos cuando…
- Están alineados con el caso de uso: Disponéis de las variables específicas necesarias para resolver el problema concreto, en lugar de un volumen masivo de información inconexa.
- Son accesibles e integrables: Los sistemas pueden compartir los datos entre si de forma automatizada y con la latencia adecuada para vuestra operativa.
- Cuentan con suficiente histórico: El volumen acumulado permite identificar patrones de comportamiento o estacionalidades reales para el algoritmo en escenarios predictivos.
- Son fiables y trazables: Podéis identificar el origen de la información y asegurar que no ha sufrido corrupciones en sus pipelines de origen.
- Cumplen con el marco regulatorio: El almacenamiento y procesamiento respetan la privacidad, seguridad y normativas de gobierno vigentes.
Tener muchos datos no significa estar preparado para la IA
Existe una brecha considerable entre acumular información y estar listos para explotarla con algoritmos de aprendizaje automático. Para un CTO o Director de Transformación Digital, la realidad técnica es muy clara: el volumen es solo una dimensión del dato y, por sí solo, no aporta valor estratégico.
Una organización puede almacenar terabytes de logs operativos diarios en servidores locales o nubes públicas. Sin embargo, si esa información carece de contexto, está estructurada en formatos propietarios cerrados o permanece aislada en silos departamentales, su explotación será extremadamente compleja y costosa. La preparación real de los datos (o data readiness) requiere analizar de forma conjunta la calidad, accesibilidad, integración, trazabilidad y gobierno de la información.
Centrarse únicamente en el almacenamiento sin un propósito definido suele generar un impacto negativo directo en el negocio: se incrementan los costes de infraestructura sin un retorno claro y los equipos técnicos dedican la mayor parte de su tiempo a tareas de limpieza manual de datos, lo que dilata los plazos de entrega.
¿Qué significa realmente tener datos preparados para IA?
La preparación de datos no es un estado global para toda la compañía. No significa que debáis iniciar un proyecto titánico para limpiar de forma impecable cada registro de vuestro CRM o ERP antes de dar el primer paso.
La pregunta correcta no es si vuestra empresa tiene buenos datos en general, sino: ¿tengo los datos adecuados para este caso de uso? Cada escenario exige fuentes, frecuencias de actualización y niveles de precisión específicos:
- Mantenimiento predictivo: Necesita lecturas de sensores de vibración o temperatura cruzadas con un registro riguroso de las paradas técnicas y averías pasadas.
- Previsión de demanda: Requiere series temporales históricas consistentes, estructuradas y sin saltos temporales inexplicables.
- Asistentes internos basados en documentación: Exigen manuales técnicos, políticas de empresa o contratos en formatos legibles (PDF estructurado, Markdown o bases de datos vectoriales), bien clasificados y libres de información obsoleta.
El foco de la empresa debe estar en evaluar el estado de las fuentes críticas asociadas a un objetivo de negocio delimitado. Entender esta distinción evita la parálisis por análisis y permite validar proyectos de forma ágil, un aspecto clave que tratamos al analizar el checklist para invertir en IA.
Las 7 preguntas para saber si tus datos están preparados
Para determinar si vuestra organización cuenta con la base necesaria, os proponemos un autodiagnóstico estructurado en siete dimensiones clave que todo responsable de tecnología debe verificar.
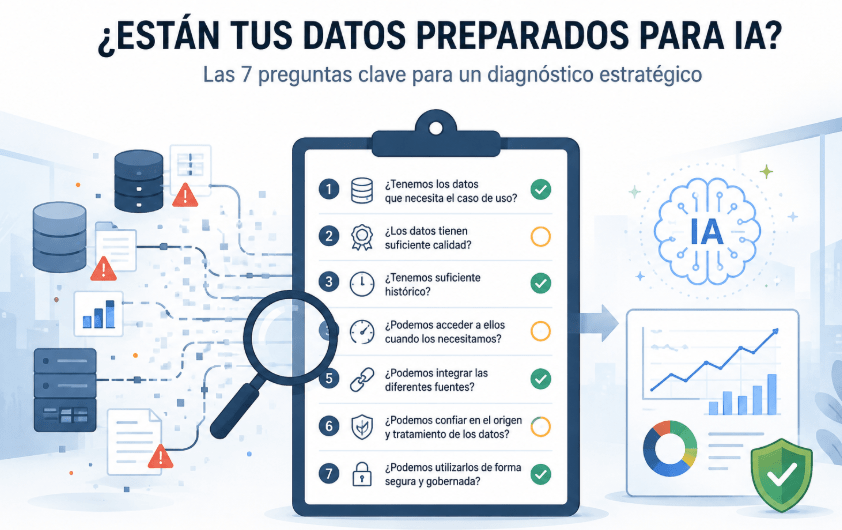
1. ¿Tenemos los datos que necesita el caso de uso?
Qué significa: Confirmar si disponéis de las variables exactas que el algoritmo requiere para aprender y tomar decisiones.
Qué comprobar: Mapear los datos de entrada indispensables para el modelo teórico y verificar si vuestros sistemas de información los están capturando de forma activa.
Señales de alerta: El caso de uso requiere predecir un comportamiento específico, pero nunca se han diseñado mecanismos de captura de la información o de las acciones previas que lo desencadenan.
Ejemplo empresarial: Supongamos que queréis predecir la fuga de clientes. Para ello debéis contar con registros de sus interacciones de soporte y uso del servicio, y no únicamente con sus datos de facturación básica.
2. ¿Los datos tienen suficiente calidad?
Qué significa: La consistencia, ausencia de valores nulos críticos y precisión en las mediciones.
Qué comprobar: Evaluar el porcentaje de registros incompletos o erróneos en las variables clave seleccionadas para el proyecto.
Señales de alerta: Presencia masiva de registros con campos en blanco en las columnas clave o variaciones en las unidades de medida entre diferentes centros de trabajo.
Ejemplo empresarial: Un sistema de inventario con registros vacíos o duplicados por fallos de sincronización compromete la precisión de cualquier modelo de previsión de stock. Para solucionar esto de raíz, estructurar una fase 0 de consultoría técnica permite depurar las fuentes y asegurar la calidad antes de comprometer el desarrollo.
3. ¿Tenemos suficiente histórico?
Qué significa: En muchos casos de uso predictivos, disponer de suficiente histórico permite identificar patrones y variaciones que pueden repetirse en el futuro.
Qué comprobar: Verificar si los sistemas conservan el histórico detallado o si se purgan los registros antiguos periódicamente para ahorrar espacio.
Señales de alerta: Sistemas configurados para sobrescribir la información histórica o bases de datos que solo conservan resúmenes agregados mensuales en lugar del detalle diario necesario.
Ejemplo empresarial: Si pretendéis realizar una previsión de ventas estacional pero solo conserváis registros de los últimos tres meses, la IA no tendrá base suficiente para identificar ciclos anuales.
4. ¿Podemos acceder a ellos cuando los necesitamos?
Qué significa: La latencia y disponibilidad técnica de las fuentes deben ser compatibles con el tiempo de respuesta que exige el negocio.
Qué comprobar: Analizar la velocidad de extracción y el método de acceso a las fuentes (APIs, consultas en tiempo real, procesos batch).
Señales de alerta: Procesos de extracción lentos que dependen de la ejecución manual de scripts o sistemas que sufren caídas de rendimiento bajo consultas recurrentes.
Ejemplo empresarial: Si el caso de uso requiere detectar fraude en una transacción en tiempo real, los datos de entrada deben estar disponibles de forma instantánea, no mediante un proceso por lotes que se ejecuta a medianoche.
5. ¿Podemos integrar las diferentes fuentes?
Qué significa: Capacidad de conectar y cruzar datos procedentes de distintos sistemas de información para dar contexto al modelo.
Qué comprobar: Identificar si existen claves primarias o identificadores únicos comunes entre las diferentes bases de datos implicadas.
Señales de alerta: Existencia de silos de información donde cada departamento utiliza sus propios códigos para identificar a un mismo cliente, producto o máquina.
Ejemplo empresarial: Imaginemos una empresa donde los registros del ERP no comparten un identificador único con el CRM o los sistemas de planta. Cruzar esa información manualmente para entrenar un modelo genera una fricción técnica y operativa insostenible a escala.
6. ¿Podemos confiar en el origen y tratamiento de los datos?
Qué significa: Disponer de trazabilidad y linaje para saber exactamente cómo se capturan, transforman y mueven los datos a lo largo de su ciclo de vida.
Qué comprobar: Auditar si existe documentación del flujo de datos o si las transformaciones se realizan mediante procesos opacos.
Señales de alerta: Hojas de cálculo compartidas donde diferentes usuarios modifican fórmulas manualmente sin control de versiones.
Ejemplo empresarial: Si un modelo de IA genera un resultado anómalo, la trazabilidad técnica permite identificar si el origen del error se encuentra en un sensor descalibrado o en una transformación incorrecta durante el proceso de extracción, facilitando la auditoría de vuestro ecosistema de datos.
7. ¿Podemos utilizarlos de forma segura y gobernada?
Qué significa: Cumplimiento de normativas de seguridad, privacidad y gobierno del dato que regulan el uso de información corporativa y personal.
Qué comprobar: Validar si se cumple el RGPD, si existen políticas de acceso basadas en roles y si se protege la propiedad intelectual de la empresa.
Señales de alerta: Almacenamiento de datos personales sin anonimizar o falta de control sobre qué usuarios internos o externos pueden extraer información crítica de la empresa.
Ejemplo empresarial: El uso de datos de clientes para alimentar un modelo de lenguaje de terceros sin anonimización previa puede suponer una vulneración grave de la normativa de privacidad y seguridad de la información.
Tabla de autodiagnóstico: mide tu preparación
Para facilitar esta evaluación a vuestro equipo directivo y técnico, hemos estructurado las preguntas clave en esta tabla de control rápida. Asignad una calificación a cada dimensión basándoos en el estado actual de vuestro caso de uso:
| Dimensión | Pregunta de autoevaluación | Estado |
|---|---|---|
| 1. Disponibilidad | ¿Tenemos los datos que necesita el caso de uso? | |
| 2. Calidad | ¿Son fiables, coherentes y completos? | |
| 3. Histórico | ¿Tenemos suficiente histórico para identificar patrones? | |
| 4. Accesibilidad | ¿Podemos acceder a ellos cuando los necesitamos? | |
| 5. Integración | ¿Podemos integrar las diferentes fuentes? | |
| 6. Confianza | ¿Podemos confiar en el origen y tratamiento de los datos? | |
| 7. Seguridad | ¿Podemos utilizarlos de forma segura y gobernada? |
Resultados del autodiagnóstico:
- De 6 a 7 respuestas positivas (🟢): Vuestra preparación de datos es óptima para arrancar el proyecto de manera ágil.
- De 4 a 5 respuestas positivas (🟠): Existen aspectos que requieren trabajo previo de ingeniería o limpieza antes de iniciar el entrenamiento del modelo.
- De 0 a 3 respuestas positivas (🔴): Tenéis bloqueos críticos. Conviene detener el proyecto temporalmente y activar nuestra fase 0 de consultoría para realizar un diagnóstico técnico exhaustivo y solucionar los problemas de calidad de datos antes de comprometer cualquier inversión.
¿Están preparados vuestros datos? El siguiente paso es comprobarlo
A estas alturas, la pregunta ya no debería ser si vuestra empresa tiene suficientes datos para hacer IA, sino si los datos necesarios para vuestro caso de uso concreto tienen la calidad, disponibilidad e integración necesarias para generar resultados fiables.
No necesitáis tener una infraestructura de datos perfecta para empezar. Necesitáis conocer sus limitaciones antes de comprometer presupuesto y recursos en un proyecto de IA.
Si después de responder a las siete preguntas anteriores habéis identificado dudas sobre la calidad de las fuentes, la disponibilidad del histórico, la integración entre sistemas o la trazabilidad de la información, el siguiente paso no debería ser empezar a desarrollar. Debería ser medir el problema sobre datos reales y determinar si el caso de uso es técnicamente viable.
En Datipic realizamos este tipo de diagnóstico para identificar qué datos necesita vuestro caso de uso, dónde están, en qué estado se encuentran y qué trabajo sería necesario realizar antes de llevar una solución de IA a producción.
Así podéis saber qué necesitáis preparar, cuánto esfuerzo requiere y qué riesgos existen antes de realizar una inversión mayor.
Si estáis valorando un proyecto de IA y queréis saber si vuestros datos están realmente preparados para llevarlo a cabo, contactad con Datipic. Analizaremos vuestra situación y os ayudaremos a definir el camino más viable desde vuestros datos actuales hasta un caso de uso de IA en producción.
